
← Ambiti di competenza/Progettazione strategica della rete · 2025
Un ottimizzatore decentralizzato per la localizzazione di strutture che risolve 11× più scenari del MILP classico
Gestione della capacità tramite code di priorità + Progressive Scenario Expansion; sul dataset reale dell'ubicazione dei Gymnasien di Dresda risolve 14 scuole × 558 studenti × 110 scenari in 24 ore, mentre il MILP classico si arena oltre i 10 scenari
14 × 558 × 110
scuole × studenti × scenari di domanda risolti sul dataset reale dei Gymnasien di Dresda
11×
più scenari risolvibili rispetto al MILP classico entro 24 ore (110 vs 10)
−95 %
di tempo di calcolo della migliore configurazione PSE rispetto alla sua versione di base su dati sintetici
Decentralizzato
i clienti scelgono liberamente con capacità gestita da code di priorità, senza assegnazione centrale
Dove collocate la prossima scuola, la prossima stazione di ricarica, il prossimo showroom? I modelli tradizionali di localizzazione presuppongono che un pianificatore centrale assegni i clienti alle strutture. Ma i clienti reali non eseguono ordini: scelgono. Abbiamo portato questa osservazione al centro dell'ottimizzazione.
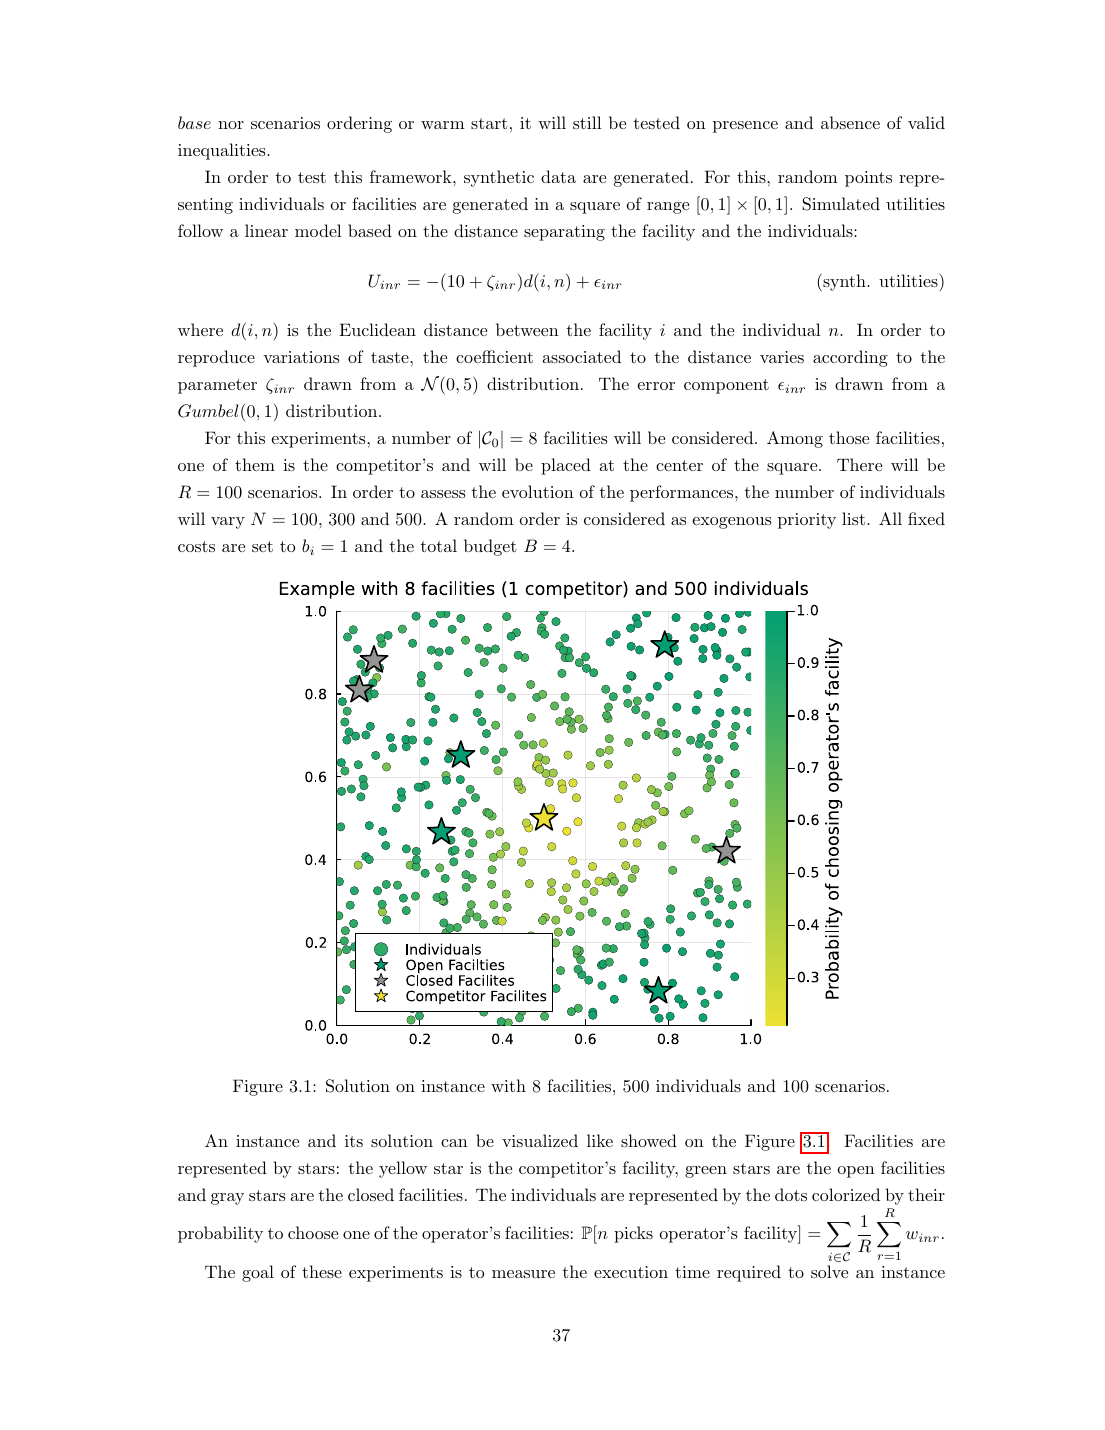
Il nostro framework integra in un unico MILP una domanda ricca basata sulla scelta discreta e vincoli di capacità (gestiti tramite code di priorità decentralizzate), insieme a un solver Progressive Scenario Expansion che gestisce istanze da 14 sedi, 558 clienti e 110 scenari di un dataset svizzero reale sull'ubicazione delle scuole: dimensioni che il MILP classico non riesce ad affrontare oltre R = 10 scenari.
Il problema
Il problema di localizzazione di impianti capacitato (Capacitated Facility Location Problem, CFLP) è un classico della ricerca operativa, ma le formulazioni tradizionali centralizzano l'assegnazione dei clienti: l'operatore decide non solo dove aprire le strutture, ma anche chi va dove. Per magazzini e centri di distribuzione va bene; è sbagliato in qualsiasi contesto in cui le persone scelgono liberamente (scuole, commercio al dettaglio, ricarica di veicoli elettrici, sanità). Applicando un modello centralizzato al problema di assegnazione scolastica, l'ottimizzatore indirizza i bambini verso la scuola che massimizza l'obiettivo del pianificatore, anche se il bambino non ci andrebbe mai.
Per correggere questa distorsione servono tre elementi contemporaneamente: una domanda ricca basata sulla scelta discreta dal lato dei clienti (che esclude probabilità di scelta in forma chiusa e impone la simulazione), vincoli di capacità espressi a livello individuale (che legano ogni cliente a tutti gli altri tramite la coda di priorità) e un ragionamento sulle quote di mercato che tenga conto della concorrenza. Riunire tutti e tre in un unico MILP trattabile, e risolverlo su istanze reali, era la sfida ancora aperta.
Cosa abbiamo costruito
Abbiamo adattato il framework MILP basato sulla simulazione di Pacheco-Paneque et al. dal pricing al contesto del CFLP, trasformando ogni scenario Monte Carlo in una traiettoria di scelta deterministica e aggregando come funzione obiettivo la quota catturata (la quota di individui che sceglie effettivamente una delle strutture dell'operatore), al posto della somma centralizzata delle utilità che distorce l'assegnazione.
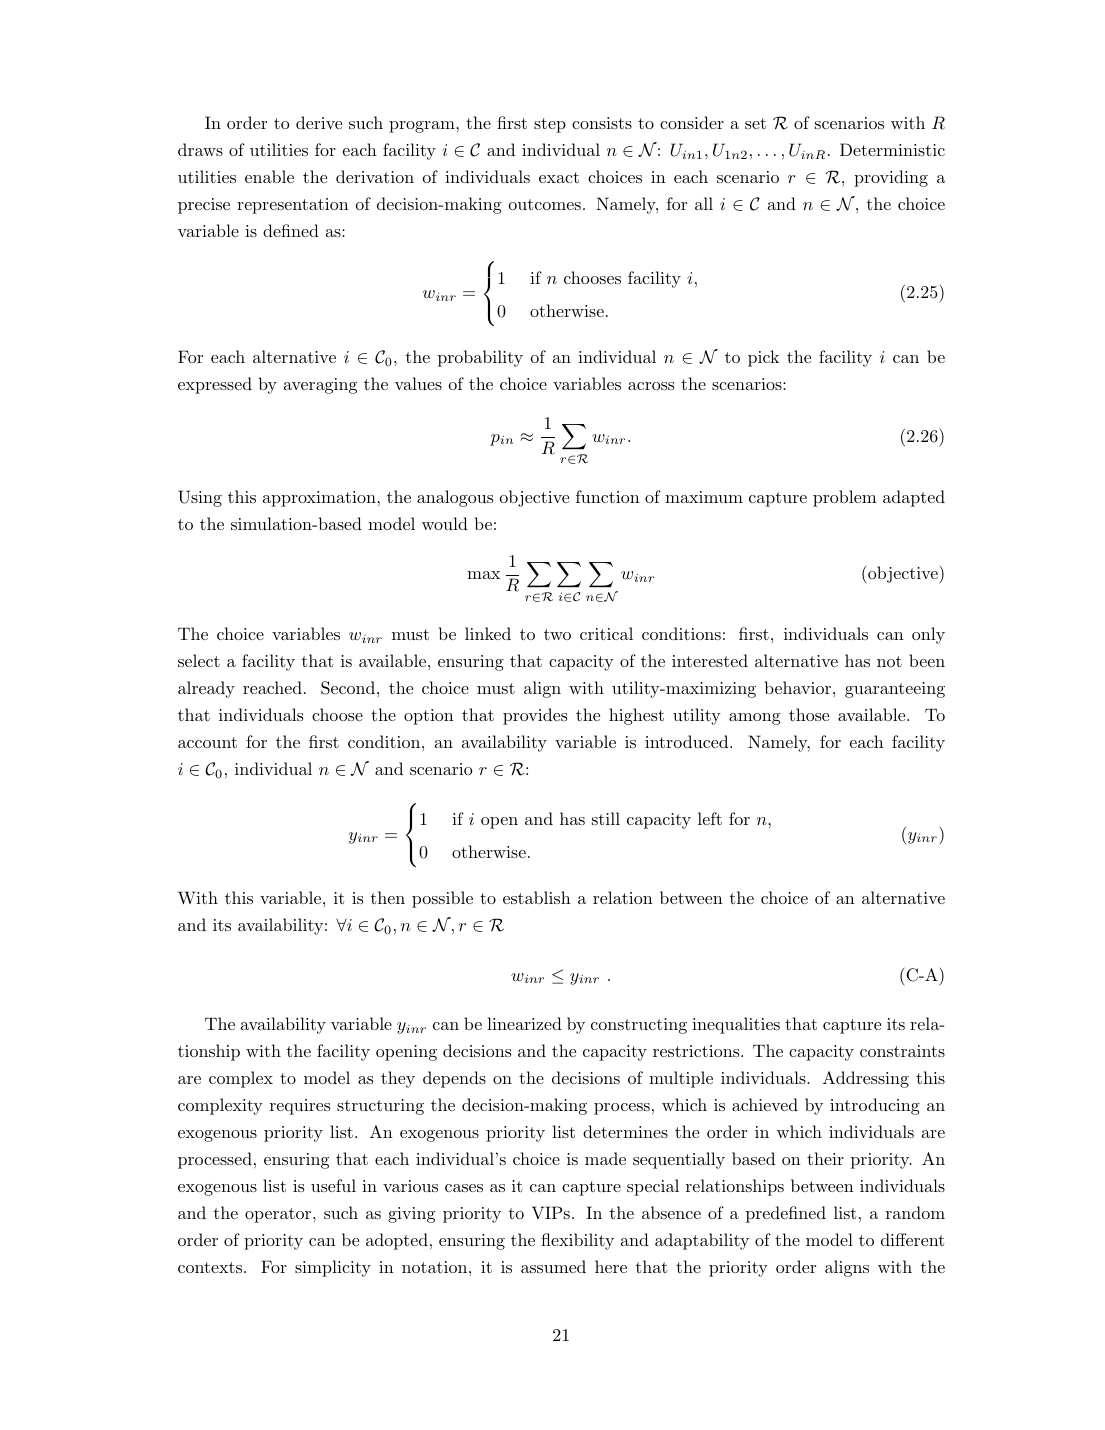
La capacità è imposta tramite liste di priorità esogene: ogni individuo viene elaborato nell'ordine della coda, e la variabile di disponibilità y_inr di una struttura passa a 0 nel momento in cui le sue selezioni cumulative raggiungono la capacità c_i. In questo modo la decisione di assegnazione è decentralizzata, mentre la formulazione resta lineare grazie ad artifici basati sull'utilità scontata.
Abbiamo aggiunto due disuguaglianze valide (effetto a catena della priorità e collegamento aggregato con il budget di capacità), una fase di pre-elaborazione delle utilità che elimina in anticipo le terne struttura/individuo/scenario dominate, e un metodo Progressive Scenario Expansion (PSE) che risolve una sequenza di sottoproblemi annidati con insiemi di scenari a crescita geometrica, ciascuno con warm start dal precedente. Il tasso di crescita in base 1,7, combinato con disuguaglianza di priorità + warm start completo + ordinamento degli scenari a entropia estesa, è la configurazione vincente.
Il risultato
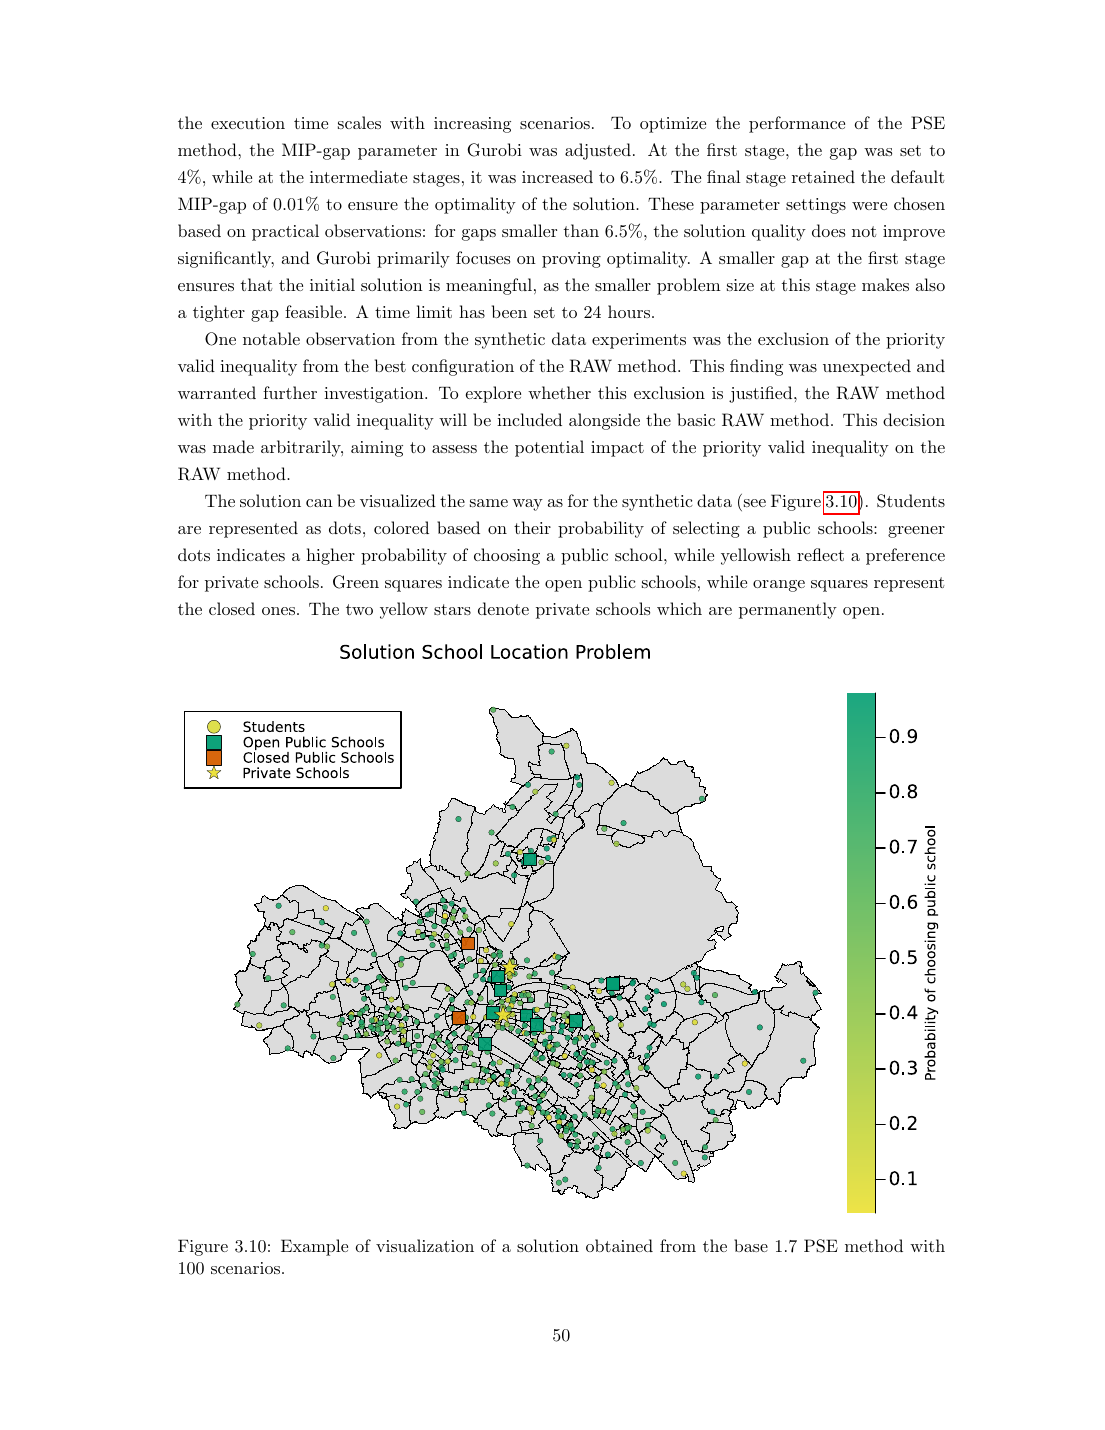
Deliverable: un framework decentralizzato per la localizzazione capacitata di strutture che integra nel MILP qualsiasi modello avanzato di scelta discreta, più un metodo risolutivo Progressive Scenario Expansion (PSE) che lo porta ben oltre i limiti del MILP classico. Sul dataset reale dell'ubicazione dei Gymnasien di Dresda (Haase e Müller 2013, 14 scuole candidate = 12 pubbliche + 2 private sempre aperte, budget di 6 milioni di euro), la PSE nella configurazione migliore risolve istanze fino a 14 scuole × 558 studenti × 110 scenari entro un limite di 24 ore. Sulle stesse istanze il MILP RAW classico si arena oltre i 10 scenari: il numero di scenari risolvibili aumenta di 11 volte.
Su dati sintetici la migliore configurazione PSE (base 1,7 + disuguaglianze valide di priorità + warm start completo + ordinamento a entropia estesa) riduce il tempo di calcolo fino al 95 % rispetto alla configurazione di base e del 28 % rispetto al MILP RAW sulle istanze risolvibili da entrambi. La sola disuguaglianza valida di priorità porta un'accelerazione del 40–60 %; il resto viene da espansione degli scenari + warm start + ordinamento basato sull'entropia.
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
Il cuore di questo lavoro consiste nel codificare in un unico MILP tre aspetti accoppiati: chi sceglie cosa (massimizzazione dell'utilità di scelta discreta a livello individuale), chi ottiene un posto (dipendenza di capacità tramite coda di priorità tra ogni coppia di clienti) e dove collocare le strutture (la decisione strategica). Il modello si colloca in un quadro di Sample Average Approximation: estraiamo R scenari Monte Carlo dei termini aleatori di utilità, fissiamo tutto all'interno di ciascuno scenario e lasciamo che le variabili binarie di scelta w_inr si propaghino attraverso i vincoli di disponibilità e di capacità. Il risultato è una formulazione interamente lineare che coglie il comportamento decentralizzato dei clienti senza mai calcolare una probabilità di scelta in forma chiusa.
Obiettivo di massima cattura. Somma su scenari, strutture e individui della variabile binaria di scelta w_inr (1 se e solo se l'individuo n sceglie la struttura i dell'operatore nello scenario r), normalizzata per 1/R. Ogni cliente sceglie esattamente un'opzione (una struttura dell'operatore oppure l'opzione esterna 0 del concorrente). Il costo complessivo di apertura è soggetto al budget B. È l'analogo decentralizzato del CFLP classico: l'operatore sceglie le aperture y_i, i clienti scelgono le strutture w_inr.
Utilità scontata z_inr. Per imporre che i clienti massimizzino l'utilità *solo sulle strutture disponibili*, mascheriamo l'utilità delle opzioni non disponibili sostituendola con una costante L inferiore a qualsiasi valore di utilità ammissibile. Il cliente sceglie quindi l'alternativa con l'utilità scontata più alta, che per costruzione è sempre una struttura disponibile. La definizione condizionale è gestita con una linearizzazione big-M.
Vincoli di capacità con coda di priorità. (A-O) La disponibilità richiede che la struttura sia aperta. (CAP1) Le selezioni cumulative della struttura i da parte di tutti i clienti con priorità più alta (m = 1, …, n − 1) non possono superare c_i − 1 se la struttura i è ancora disponibile per n. (CAP2) Se la struttura i è aperta e non ancora piena quando arriva n, *deve* essere marcata come disponibile: questo impedisce al solver di chiudere artificialmente una struttura a un cliente solo per migliorare l'obiettivo centralizzato. È (CAP2) a rendere il framework realmente decentralizzato anziché un rilassamento.
Disuguaglianza valida a catena di priorità. Se la struttura i era disponibile per il cliente n e il cliente n non l'ha scelta, allora deve essere ancora disponibile per il cliente n+1. Questa disuguaglianza da sola riduce il tempo di calcolo del 40–60 %: comunica a Gurobi una relazione strutturale tra variabili di disponibilità consecutive che la formulazione originale lascia implicita. Senza di essa, il solver la riscopre da zero a ogni nodo.
Pre-elaborazione delle utilità. Per ogni terna (i, n, r) calcoliamo limiti inferiori e superiori dell'utilità dell'operatore rispetto alla migliore alternativa. Se l'operatore domina il concorrente sull'intero intervallo ammissibile, il cliente è catturato in modo deterministico: si eliminano le variabili di scelta della terna e se ne aggiunge il contributo come costante all'obiettivo. Simmetricamente, se il concorrente domina l'operatore sull'intero intervallo, la terna non viene mai catturata e la si scarta. In entrambi i casi la dimensione del modello si riduce prima ancora che il solver parta.
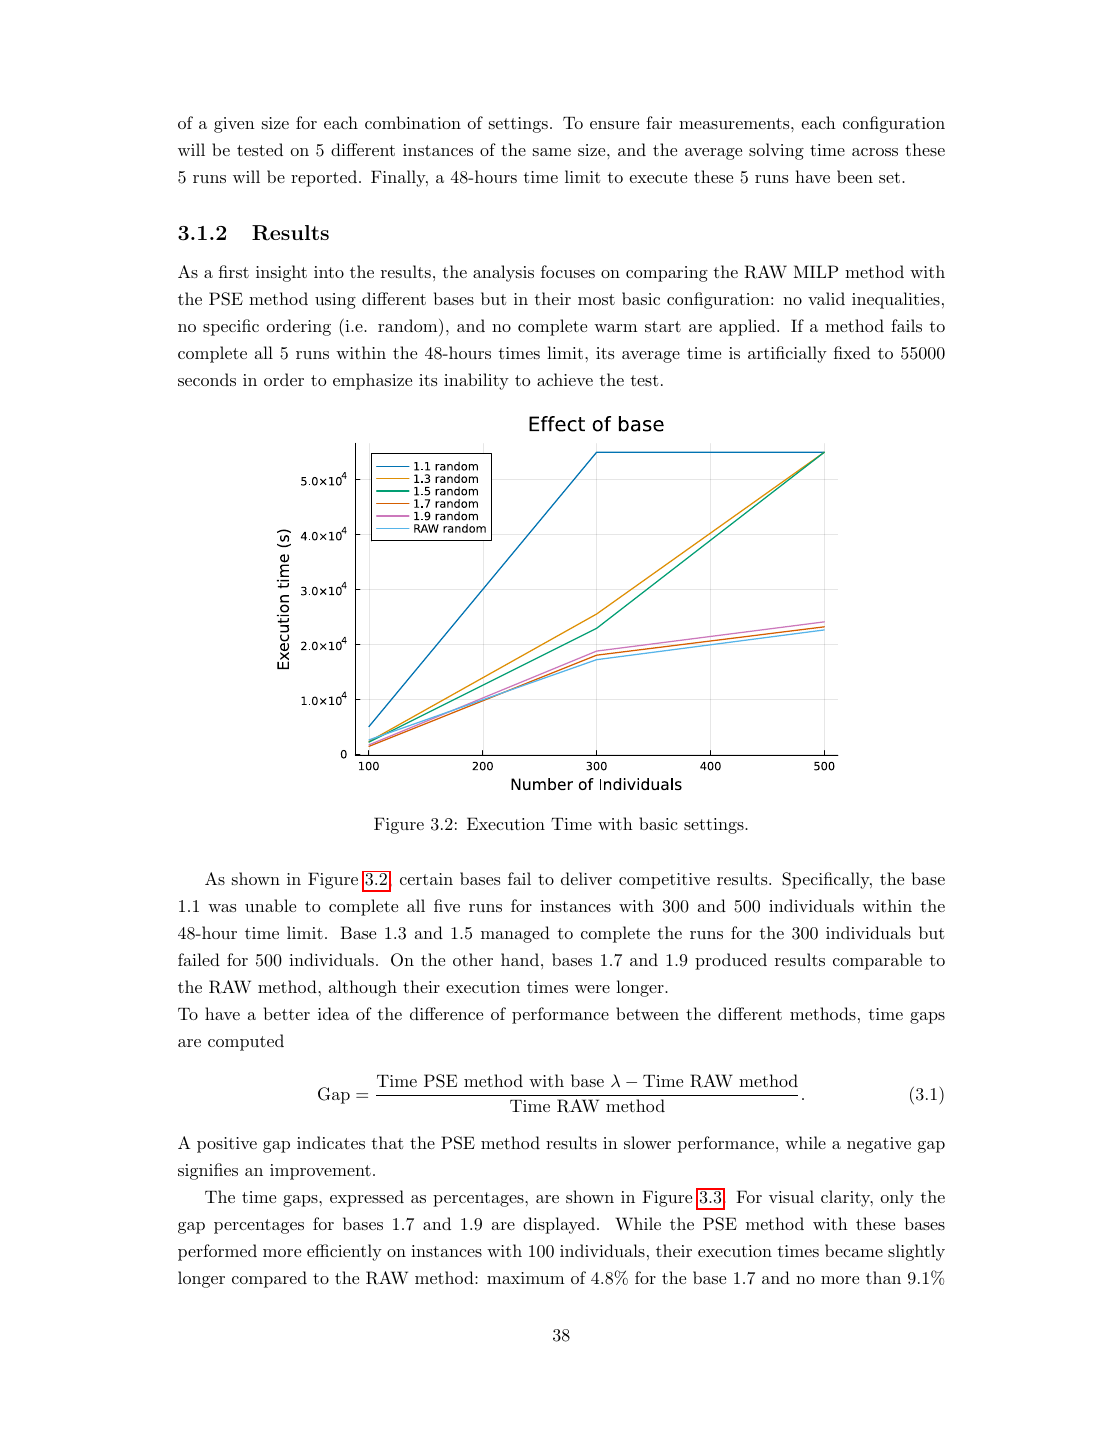
Progressive Scenario Expansion. Invece di risolvere fin dall'inizio il MILP completo con R scenari, si risolve una sequenza di sottoproblemi annidati in cui l'insieme degli scenari cresce di un fattore moltiplicativo fisso λ. Ogni sottoproblema parte in warm start dal precedente. Il tasso di crescita λ = 1,7 è stato individuato empiricamente come punto di equilibrio ottimale: abbastanza grande da terminare in un numero ragionevole di fasi, abbastanza piccolo perché sottoproblemi consecutivi condividano abbastanza struttura da rendere il warm start davvero informativo. Con λ = 1,1 il metodo si esaurisce in troppe fasi; con λ ≥ 2 si perde il vantaggio del warm start.
Ordinamento degli scenari a entropia estesa. Per decidere quali scenari entrino per primi nell'insieme attivo, raggruppiamo gli scenari in base al loro schema di scelta realizzato e li ordiniamo per entropia dell'appartenenza ai cluster: gli scenari ad alta entropia vengono per primi perché contengono più informazione sul panorama delle scelte. Un ordinamento casuale, al contrario, spreca spesso le prime fasi su scenari quasi identici tra loro, vanificando i primi warm start.
È la combinazione PSE + disuguaglianze valide + pre-elaborazione delle utilità a trasformare un MILP da manuale in uno strumento capace di risolvere davvero istanze realistiche di localizzazione con scelta decentralizzata dei clienti. Nessuno dei quattro ingredienti è sufficiente da solo: il metodo RAW con le sole disuguaglianze di priorità risolve 10 scenari; la PSE senza disuguaglianze di priorità è più lenta del RAW; la PSE con tutte le componenti è l'unico metodo che supera i 50 scenari sul dataset delle scuole. Il limite principale raggiunto (14 scuole × 558 studenti × 110 scenari in 24 h 57 min) è ancora lontano dal dataset originale di 26 scuole × 1'343 studenti, che la tesi indica come naturale prossima direzione di ricerca, probabilmente tramite i metodi euristici sviluppati nel filone correlato BHA / BHAMSLE.
Benchmark
Test sul dataset svizzero di Haase e Müller (2013) sull'ubicazione delle scuole: 14 scuole candidate (12 pubbliche + 2 private sempre aperte), costi e capacità reali per scuola, distribuzioni reali degli studenti e profili di scelta. Tempi in secondi; limite di tempo di 24 ore (86'400 s). Ogni metodo è testato nella sua configurazione «migliore»: RAW + disuguaglianza di priorità; PSE con base 1,7 + disuguaglianza di priorità + warm start completo + ordinamento a entropia estesa. «DNF» (did not finish) = non concluso entro 24 h.
| Scenari R | RAW + VI di priorità | PSE base 1,7 (migliore) | Rapporto PSE 1,7 / RAW |
|---|---|---|---|
| 1 | 35 s | 49 s | 1,40× |
| 5 | 444 s | 1'312 s | 2,95× |
| 10 | 3'861 s | 4'511 s | 1,17× |
| 50 | DNF (> 86'400 s) | 7'936 s | 0,09× (PSE 10× più veloce) |
| 100 | DNF (> 86'400 s) | 21'530 s | 0,25× (PSE 4× più veloce) |
Due regimi. Sotto R ≈ 10 scenari vince il MILP RAW: non ha senso espandere gli scenari quando l'istanza completa è già piccola. Sopra R ≈ 10 il MILP RAW crolla (il numero di variabili cresce come J × N × R e il branch-and-cut di Gurobi non riesce a stare al passo con la combinatoria per scenario), e il metodo PSE è l'unico che arriva in fondo. Il regime a 50 scenari è il punto di svolta in cui la PSE passa da «più lenta» a «unica opzione che funziona», ed è esattamente il regime di cui hanno bisogno i problemi pratici di localizzazione basati sulla simulazione (la letteratura richiede in genere 100–1'000 scenari per stime stabili delle probabilità di scelta). Su dati sintetici con dimensione controllata delle istanze, la configurazione migliore PSE 1,7 è più veloce dall'85 al 95 % rispetto alla propria configurazione di base (nessuna disuguaglianza, ordinamento casuale, warm start parziale), a dimostrazione che ogni componente contribuisce.
Dalla documentazione
Tecniche
- Localizzazione capacitata decentralizzata
- MILP basato sulla simulazione (SAA)
- Scelta discreta con concorrenti
- Progressive Scenario Expansion
- Disuguaglianze valide a catena di priorità
- Ordinamento degli scenari basato sull'entropia
Stack
- Julia
- Gurobi 10.0.1
- Dataset svizzero sull'ubicazione delle scuole (Haase & Müller 2013)
Un problema simile?