
← Ambiti di competenza/Domanda di trasporto · Stima · 2024
Insiemi di scelta congiunti per modo e destinazione, ora operativi nella pipeline OASIS dell'EPFL
Il primo metodo a cogliere congiuntamente l'accoppiamento tra modo e destinazione, con un termine di correzione del bias in forma chiusa che si integra in qualsiasi stimatore di modelli basati sulle attività
OASIS
oggi il modulo di generazione degli insiemi di scelta della pipeline ABM dell'EPFL
Forma chiusa
termine di correzione del bias integrabile in qualsiasi stimatore ABM di massima verosimiglianza
Modo + destinazione congiunti
il primo metodo a cogliere l'accoppiamento, non un solo asse alla volta
STRC 2022
lavoro in co-autoria, validato su 3'536 spostamenti del Microcensimento svizzero
I modelli di domanda di trasporto basati sulle attività reggono o cadono sui loro insiemi di scelta. Usate l'universo di tutte le destinazioni possibili e la stima dei parametri procede a passo di lumaca. Usate un filtro ingenuo e introducete una distorsione nel modello. Usate euristiche rigide basate sulla distanza e non riuscite a cogliere l'interazione tra modo e destinazione.
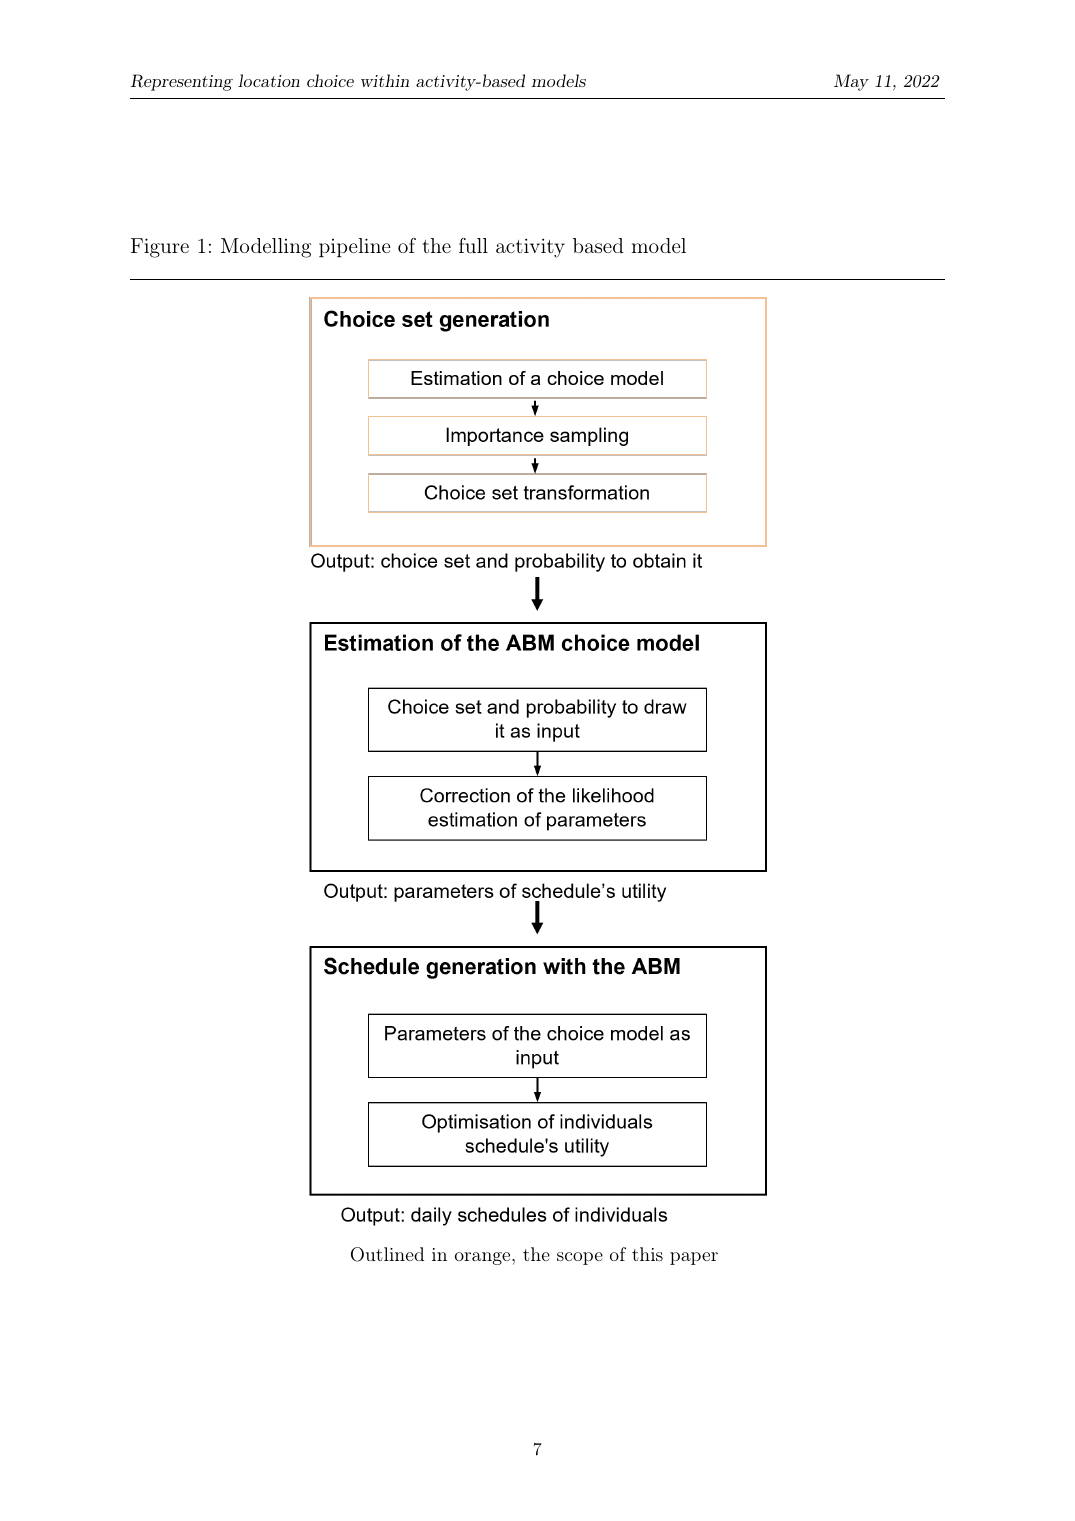
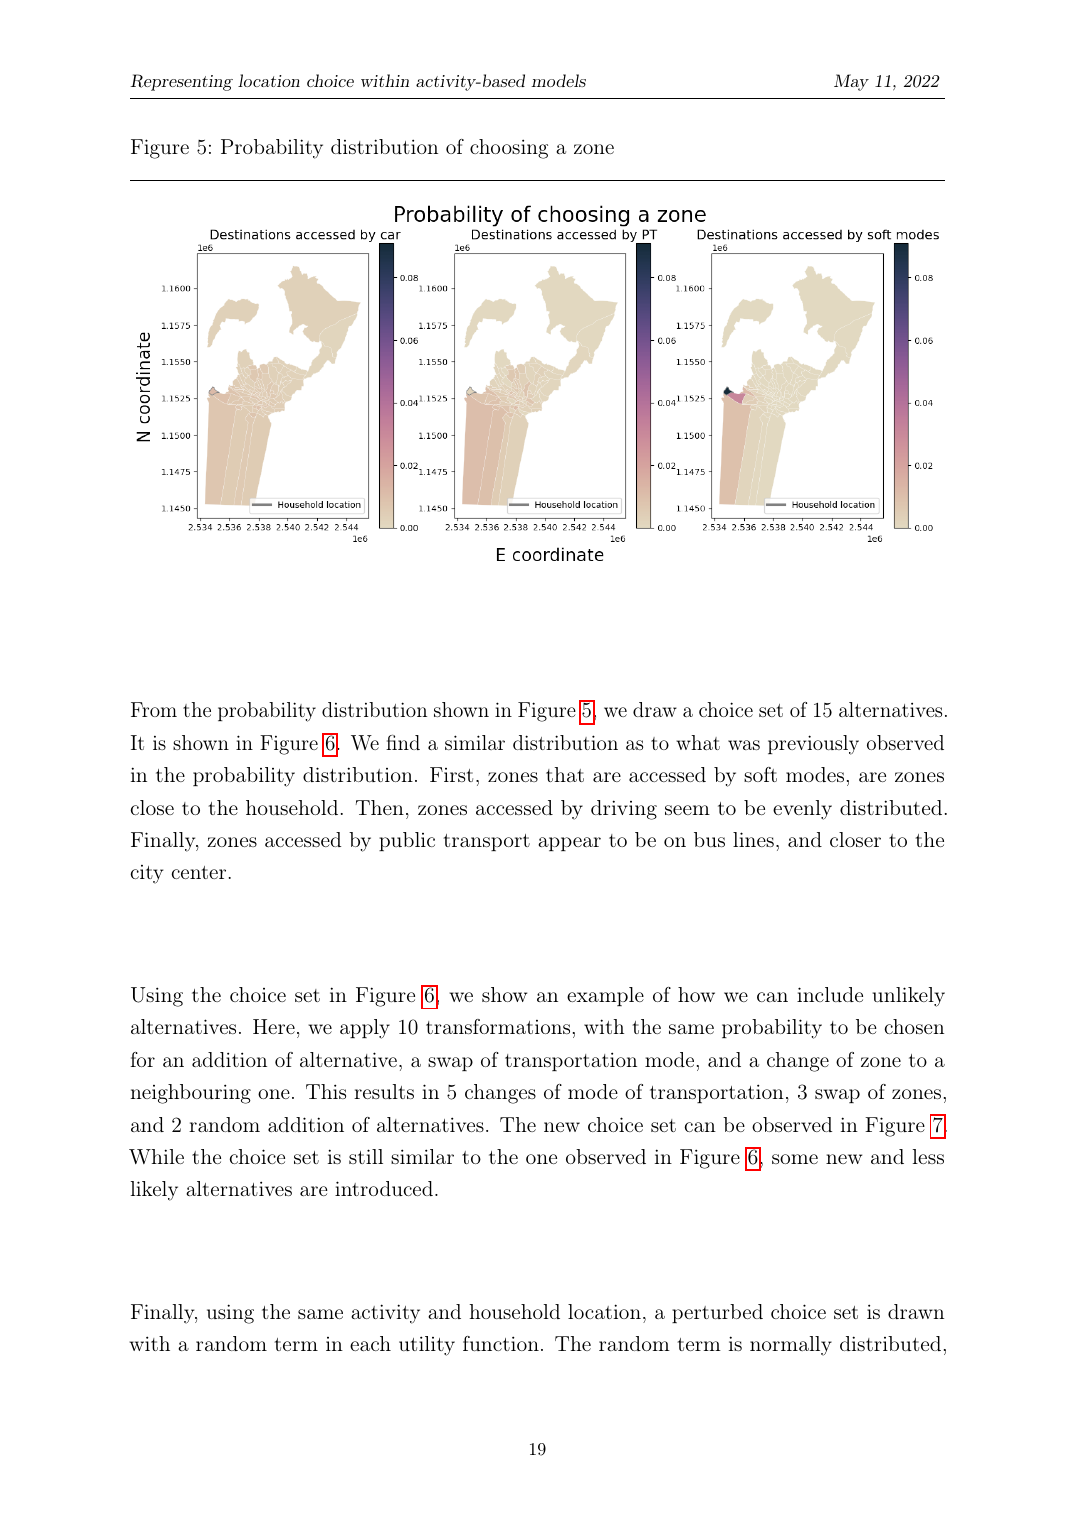
Siamo co-autori di un approccio stocastico congiunto alla generazione degli insiemi di scelta: si stima un cross-nested logit sulle combinazioni osservate di modo e destinazione, si campiona tramite importance sampling dalla distribuzione di probabilità risultante e si perturba l'insieme campionato con tre operatori casuali per inserire alternative improbabili. Ottenete così insiemi competitivi realistici per la simulazione e un mix controllato di opzioni probabili e improbabili per una stima non distorta dei parametri.
Il problema
Per decenni, nella ricerca sulla modellazione basata sulle attività, la generazione degli insiemi di scelta è stata trattata come una fase di pre-elaborazione fissa e spesso arbitraria, tipicamente basata su filtri di distanza o di tempo definiti da regole (il prisma spazio-temporale di Hägerstrand, le ellissi di attività di Schönfelder-Axhausen, il rubber-banding di Scherr et al.). Il risultato sono stime dei parametri distorte, simulazioni meno realistiche e nessun modo di cogliere il reale accoppiamento tra la scelta del modo e quella della destinazione (l'auto rende accessibili destinazioni irraggiungibili con i trasporti pubblici; dover viaggiare nell'ora di punta rende più attraenti le destinazioni vicine).
La sfida: costruire un metodo che generi insiemi di scelta utili sia per la simulazione (alternative competitive) sia per la stima (un mix controllato di opzioni probabili e improbabili), e che colga l'interazione tra modo e destinazione anziché trattarli uno alla volta. Con 88 zone × 3 modi, anche in un piccolo caso di studio, si hanno 264 alternative universali per individuo; per le 8'000 zone della Svizzera l'insieme universale ne conta 24'000.
Cosa abbiamo costruito
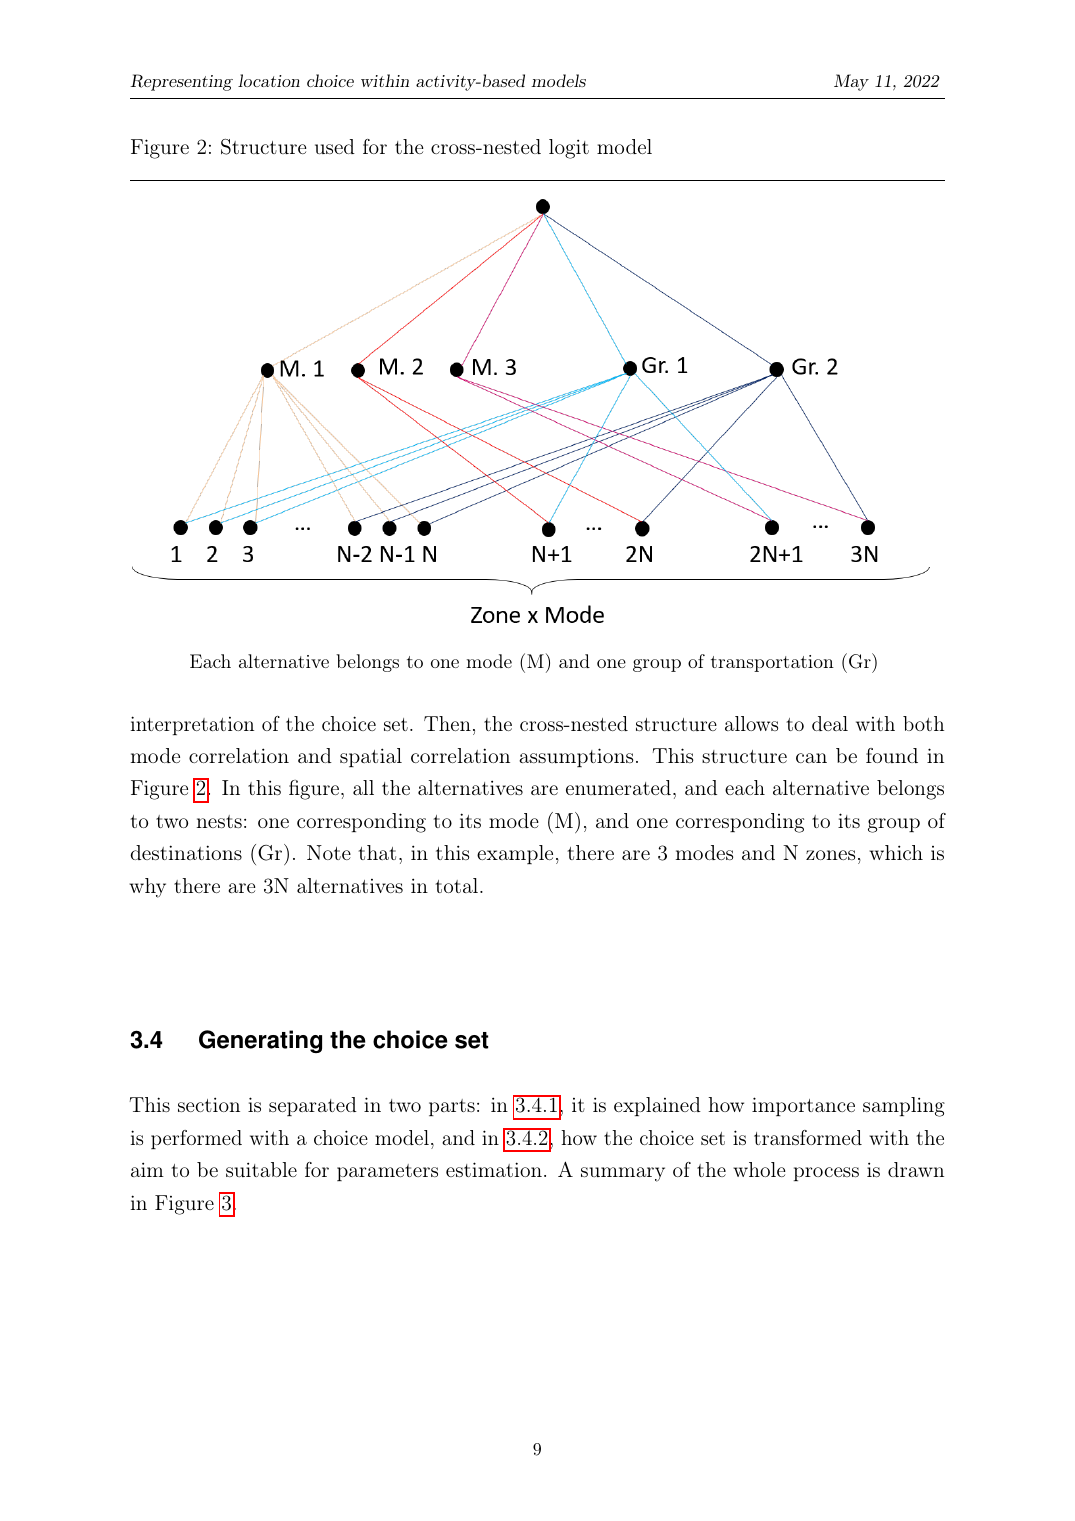
Stimiamo un cross-nested logit (CNL) sulle combinazioni osservate di modo e destinazione tratte da un diario degli spostamenti. La struttura CNL colloca ogni alternativa contemporaneamente in due nidi: uno corrispondente al suo modo di trasporto (correlazione modale tra alternative raggiunte nello stesso modo) e uno corrispondente al suo gruppo geografico (correlazione spaziale tra zone vicine allo stesso polo di attrazione).
Dal CNL stimato estraiamo per importance sampling N alternative per individuo, formando un insieme di scelta Ĉ_n. La probabilità di ottenere uno specifico insieme di scelta è in forma chiusa (il prodotto delle probabilità delle singole estrazioni, corrette per il campionamento senza reinserimento), il che significa che possiamo calcolare il termine correttivo necessario per una stima di massima verosimiglianza non distorta a valle.
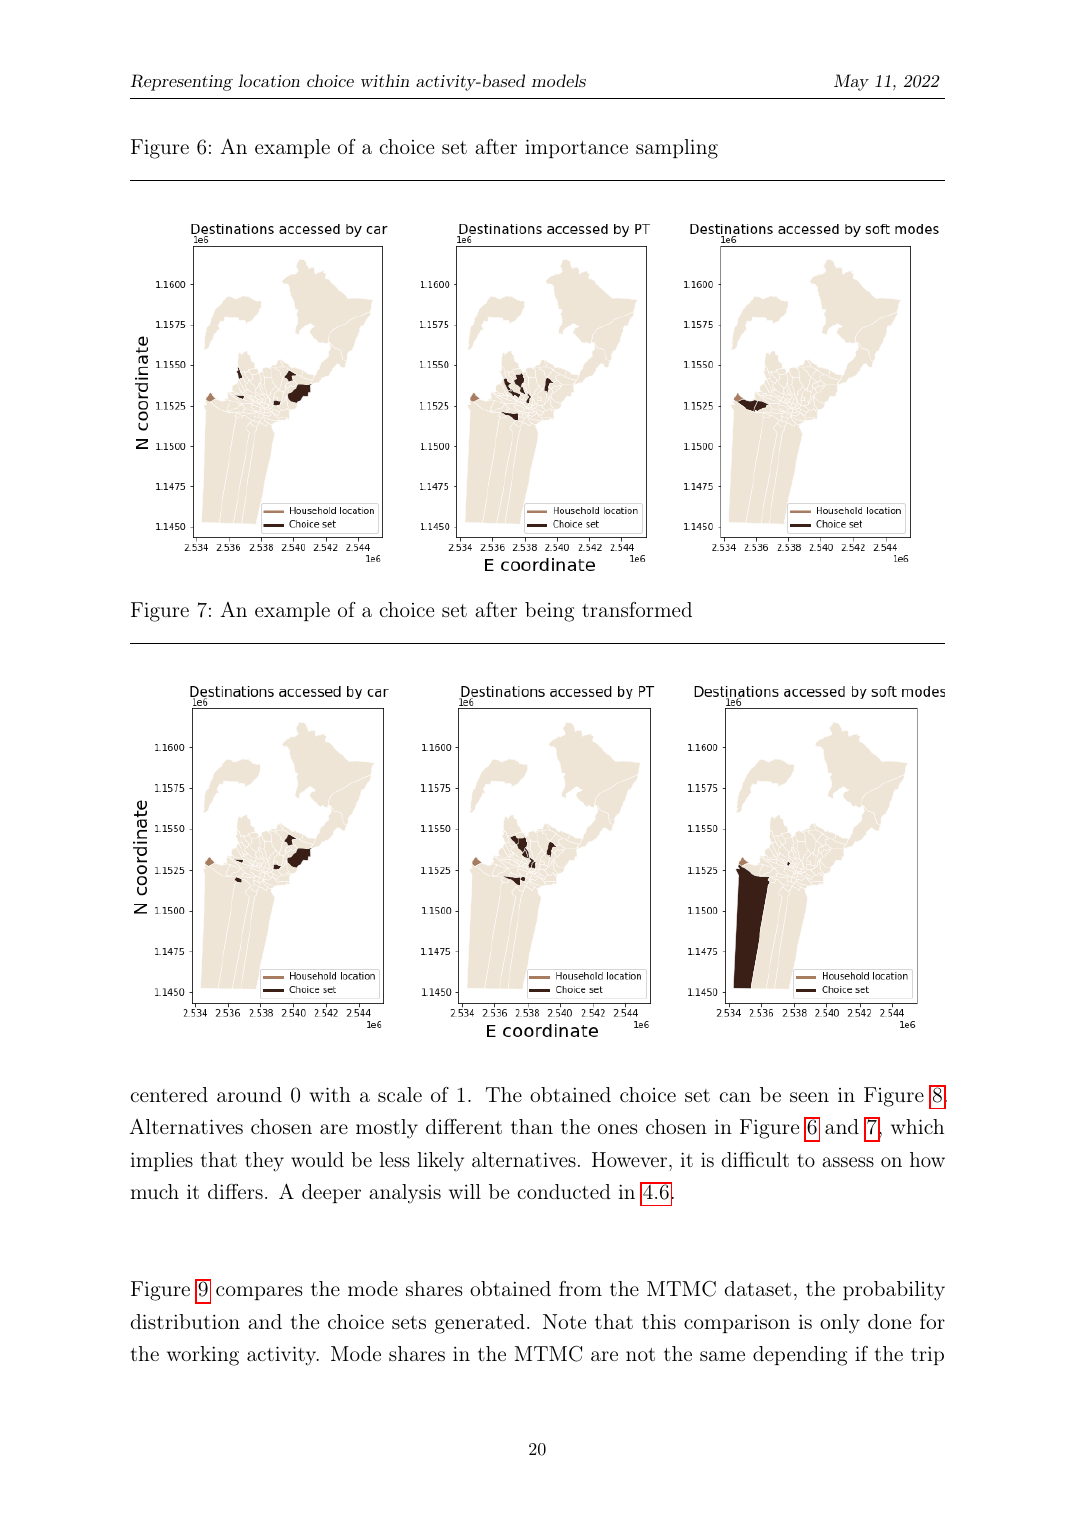
Perturbiamo l'insieme ottenuto per importance sampling con tre operatori: (1) aggiungere un'alternativa casuale non presente nell'insieme, (2) cambiare il modo di un'alternativa con un modo diverso, (3) spostare la destinazione di un'alternativa in una zona adiacente. Ogni operatore ha una probabilità in forma chiusa che concorre alla P(Ĉ_n) complessiva usata nel termine di correzione del bias. In questo modo si inseriscono le alternative improbabili necessarie per identificare perché quella scelta sia preferita.
Abbiamo validato il metodo sul Microcensimento mobilità e trasporti 2015, limitandoci a 3'536 spostamenti con destinazione Losanna. Sugli stessi dati, il CNL ha un adattamento significativamente migliore di un logit semplice (rapporto di verosimiglianza 46,58, χ²(5, 95 %) = 11,07, ipotesi nulla rifiutata con elevata confidenza).
Il risultato
Deliverable: una metodologia con una probabilità di campionamento P(Ĉ_n) in forma chiusa, che consente a qualsiasi stimatore di modelli basati sulle attività a valle di aggiungere un unico termine correttivo moltiplicativo e ottenere stime dei parametri non distorte. La generazione degli insiemi di scelta è oggi il modulo corrispondente della pipeline di modellazione basata sulle attività OASIS presso Transp-OR dell'EPFL, ed è stata presentata alla STRC 2022.
Sul caso di studio di Losanna (88 zone × 3 modi, 3'536 spostamenti del microcensimento), il cross-nested logit ha un adattamento significativamente migliore di un logit semplice (LR = 46,6 vs χ²(5, 95 %) = 11,07, ipotesi nulla rifiutata con elevata confidenza), a conferma che l'accoppiamento congiunto tra modo e destinazione è reale e merita di essere modellato — non un'ipotesi che la precedente generazione di filtri basati su regole potesse cogliere.
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
Il nucleo metodologico è composto da tre elementi che si incastrano: una specificazione cross-nested logit per l'utilità congiunta di modo e destinazione, una regola di importance sampling che estrae gli insiemi di scelta dalla distribuzione di probabilità del CNL e una fase di perturbazione che inserisce alternative improbabili mantenendo in forma chiusa la probabilità di campionamento complessiva. La probabilità di campionamento in forma chiusa è la chiave: è ciò che permette allo stimatore del modello basato sulle attività, a valle, di aggiungere un termine correttivo e ottenere stime dei parametri non distorte.
Utilità congiunta di modo e destinazione. Per l'individuo n che sceglie la zona z e il modo m: una costante specifica dell'alternativa ASC_m per ciascun modo; un coefficiente del tempo di percorrenza specifico per modo β^TIME_m × TT_zm; un effetto del tipo di zona (urbana/rurale/intermedia); e un effetto di densità dipendente dall'attività ρ^a_z = densità di posti di lavoro, densità di popolazione o la loro somma, diverso per lavoro, formazione, tempo libero, acquisti e altro. I coefficienti di densità per attività permettono al modello di esprimere relazioni come «un'attività lavorativa predilige zone ad alta densità di posti di lavoro» o «un'attività di formazione predilige zone a bassa densità di popolazione», senza perdere l'accoppiamento tra modo e destinazione.
Probabilità di scelta del cross-nested logit. Ogni alternativa i appartiene contemporaneamente a due nidi (un nido modale e un nido di gruppo geografico), con grado di appartenenza α_ik ∈ [0, 1]. I parametri di scala µ_k > 1 colgono la correlazione all'interno di ciascun nido, stimata empiricamente da 1,63 (trasporto pubblico) fino a 7,06 (auto) sui dati di Losanna. Il CNL ha un adattamento significativamente migliore di un logit semplice (test LR 46,58 vs χ²(5) = 11,07).
Probabilità di importance sampling senza reinserimento. La probabilità di estrarre uno specifico insieme di scelta Ĉ_n di dimensione N è il prodotto di N probabilità di singola estrazione: il numeratore è la probabilità di scelta CNL della j-esima alternativa, il denominatore rinormalizza dopo che ogni estrazione precedente è stata rimossa dal supporto. Il tutto è in forma chiusa, ed è proprio questo il punto: la stima di massima verosimiglianza a valle conosce esattamente P_IS e può calcolare il termine di correzione del bias senza integrazione Monte Carlo.
Probabilità degli operatori di perturbazione. Dopo l'importance sampling, tre operatori inseriscono alternative improbabili: «add» sceglie un'alternativa casuale non presente nell'insieme (uniformemente tra le ZM − N alternative al di fuori di Ĉ_n); «swap» sceglie un'alternativa e ne cambia il modo (1/N per scegliere l'alternativa × 1/(M−1) per scegliere un modo diverso); «change» sposta la zona di un'alternativa in una zona adiacente casuale (1/N × 1/Nei_j, dove Nei_j è il numero di zone geograficamente adiacenti). Ogni operazione non è valida se l'alternativa risultante è già nell'insieme, caso gestito per rigetto.
Probabilità di campionamento complessiva dopo T perturbazioni. Il modellista sceglie le tre probabilità di selezione degli operatori (p_add, p_swap, p_change, la cui somma è 1) e il numero di perturbazioni T. La probabilità totale P(Ĉ_n) è il prodotto della probabilità di importance sampling e delle probabilità delle singole perturbazioni, ancora in forma chiusa: è questo che rende l'intera costruzione utilizzabile nella stima di massima verosimiglianza a valle.
Log-verosimiglianza corretta per la stima ABM a valle. Nota la probabilità di inclusione di ciascuna alternativa P(j ∈ Ĉ_n) (calcolabile a partire da P(Ĉ_n)), lo stimatore di massima verosimiglianza del modello basato sulle attività può correggere il fatto che la stima avviene su un insieme di scelta campionato anziché su quello universale. Senza questo termine correttivo i parametri risultano distorti: le alternative sovrarappresentate dal campionatore appaiono più attraenti di quanto siano realmente. Il risultato classico di McFadden si generalizza a questo caso perché P_IS è in forma chiusa.
Test di specificazione: CNL vs logit semplice. La struttura cross-nested ha 5 parametri liberi in più rispetto alla versione vincolata a logit (tutti gli α a 0/1 e tutti i µ a 1). La statistica del rapporto di verosimiglianza, pari a 46,58, supera ampiamente il valore critico del χ² al 95 % di confidenza: la struttura CNL si adatta significativamente meglio. In concreto, nei dati esistono una reale correlazione modale e una reale correlazione spaziale, e modellarle migliora l'adattamento quanto basta a giustificare i parametri aggiuntivi.
La P(Ĉ_n) in forma chiusa è l'elemento portante dell'intera costruzione. Una volta che l'avete, tutto l'apparato di modellazione basata sulle attività a valle (stima basata sulla verosimiglianza, simulazione con i parametri stimati, previsione tramite importance sampling) funziona correttamente senza dover tenere traccia di quali alternative il campionatore abbia visto o meno, perché la correzione del bias è contenuta in un unico fattore moltiplicativo. Il CNL sovrapposto è la scelta di modellazione che rende esplicita l'interazione congiunta tra modo e destinazione; senza di esso (con un logit semplice), la proprietà IIA imporrebbe schemi di sostituzione irrealistici ogni volta che si aggiungono o si tolgono alternative.
Benchmark
Stima del cross-nested logit sul Microcensimento mobilità e trasporti 2015 (3'536 spostamenti a Losanna, 88 zone × 3 modi, biogeme 3.2.6). I valori riportati sono le stime dei coefficienti con errori standard robusti. ASC = costante specifica dell'alternativa; B_TIME = coefficiente del tempo di percorrenza per modo; B_<x>_<attività> = effetto di densità per tipo di attività. I 5 parametri µ sono i coefficienti di scala dei nidi (devono essere > 1 per avere senso; > 1 indica correlazione all'interno del nido).
| Parametro | Valore | Err. std robusto | Test t robusto | Valore p robusto |
|---|---|---|---|---|
| ASC_car | −1,99 | 0,118 | −16,8 | ≈ 0 |
| ASC_pt | −1,73 | 0,190 | −9,12 | ≈ 0 |
| B_TIME_softmodes | −0,537 | 0,0124 | −43,3 | ≈ 0 |
| B_TIME_car | −0,457 | 0,0818 | −5,59 | 2,2e-08 |
| B_TIME_pt | −0,327 | 0,0589 | −5,55 | 2,9e-08 |
| B_JobD_WORK | +0,00335 | 0,00136 | +2,48 | 0,013 |
| B_PopD_EDUC | −0,0251 | 0,00576 | −4,36 | 1,3e-05 |
| B_PopD_LEIS | −0,0189 | 0,00291 | −6,51 | 7,3e-11 |
| B_JobD_PopD_SHOP | +0,00712 | 0,00334 | +2,13 | 0,033 |
| MU_CAR (scala del nido) | 7,06 | 4,99 | 1,41 | 0,157 |
| MU_PT (scala del nido) | 1,63 | 0,433 | 3,76 | 1,7e-04 |
| MU_CENTER (nido geografico) | 1,66 | 0,118 | 14,1 | ≈ 0 |
| MU_EAST (nido geografico) | 2,05 | 0,186 | 11,0 | ≈ 0 |
| MU_WEST (nido geografico) | 1,98 | 0,177 | 11,2 | ≈ 0 |
Tre risultati sostanziali. Primo, le costanti specifiche delle alternative per l'auto (−1,99) e per il trasporto pubblico (−1,73) sono entrambe negative: a parità di tempo di percorrenza e degli altri fattori, la mobilità lenta (a piedi o in bicicletta) è preferita in partenza, in coerenza con i brevi spostamenti di un dataset di Losanna di 0,5–5 km. Secondo, i coefficienti di densità cambiano segno a seconda dell'attività: le attività lavorative prediligono zone ad alta densità di posti di lavoro (+0,0034 / posto di lavoro·m^−2), quelle di tempo libero e di formazione zone a bassa densità di popolazione (da −0,019 a −0,025 / persona·m^−2). È esattamente lo schema di sostituzione che un logit semplice non riesce a cogliere: attività diverse attraggono verso parti diverse della città. Terzo, i parametri dei nidi geografici (MU_CENTER = 1,66; MU_EAST = 2,05; MU_WEST = 1,98) sono tutti significativamente superiori a 1, a conferma di una reale correlazione spaziale: le zone dello stesso gruppo condividono caratteristiche non osservate che attraggono collettivamente gli individui. La stima elevata di MU_CAR (7,06), con significatività marginale, è un artefatto dovuto al campione ridotto (solo 1'316 spostamenti in auto con 276 alternative ciascuno).
Dalla documentazione
Tecniche
- Modello cross-nested logit (CNL)
- Importance sampling per gli insiemi di scelta
- Distribuzione di probabilità congiunta modo/destinazione
- Domanda di trasporto basata sulle attività
- Correzione del bias nella stima di DCM
- Operatori di perturbazione stocastica
Stack
- Python
- Biogeme 3.2.6
- Microcensimento mobilità e trasporti 2015
- Matrici delle distanze MATSim
Un problema simile?