
← Ambiti di competenza/R&S algoritmica · 2025
Programmazione a vincoli 750× più veloce del MILP nello scheduling basato sulle attività
Una formulazione CP-SAT idiomatica, con un risultato negativo: qui gli intervalli NO_OVERLAP rallentano attivamente il calcolo. È il tipo di giudizio sulla scelta del paradigma che offriamo ai clienti
750×
CP indicizzata vs MILP con 5 attività
36×
CP indicizzata vs traduzione diretta in CP
1,5–2× più lente
variabili intervallo: un risultato negativo
TRANSP-OR 2022
rapporto co-supervisionato
Quando tutti usano il MILP, a volte conviene cambiare paradigma. Il team ha preso il MILP pubblicato da Pougala, Hillel e Bierlaire (2021) per lo scheduling basato sulle attività, lo ha ricostruito in programmazione a vincoli con il solver CP-SAT di OR-Tools e ha dimostrato che una CP idiomatica (implicazioni come vincoli nativi, vincoli globali ELEMENT, propagazione al posto del branch-and-bound) supera il MILP di 750× sulle istanze a 5 attività.
La lezione più profonda, che è il valore che offriamo ai clienti: non tutti i problemi di ottimizzazione meritano lo stesso martello. C'è anche un risultato negativo: le variabili intervallo e NO_OVERLAP, spesso presentate come la funzionalità decisiva di CP-SAT per lo scheduling, qui *non* aiutano, perché il vincolo di coerenza temporale fissa già la sequenza delle attività.
Il problema
Lo scheduling basato sulle attività con massimizzazione dell'utilità (Pougala et al. 2021) è l'approccio econometrico moderno alla previsione della domanda di trasporto: coglie il compromesso congiunto tra partecipazione alle attività, orario, durata, luogo e modo, che i vecchi ABM sequenziali basati su regole non considerano. Il prezzo è un MILP brutale: il tempo di simulazione dell'intera popolazione cresce di circa un ordine di grandezza per ogni attività aggiunta per individuo, il che è impraticabile quando occorre simulare milioni di agenti.
La domanda naturale (un paradigma di risoluzione diverso si adatterebbe meglio al problema?) era rimasta senza risposta nella letteratura sullo scheduling basato sulle attività. Le traduzioni ingenue da un paradigma all'altro raramente aiutano; la vera domanda è se una CP *idiomatica*, che usa vincoli globali e motori di propagazione capaci di sfruttare la struttura combinatoria discreta, possa superare un MILP raffinato.
Cosa abbiamo costruito
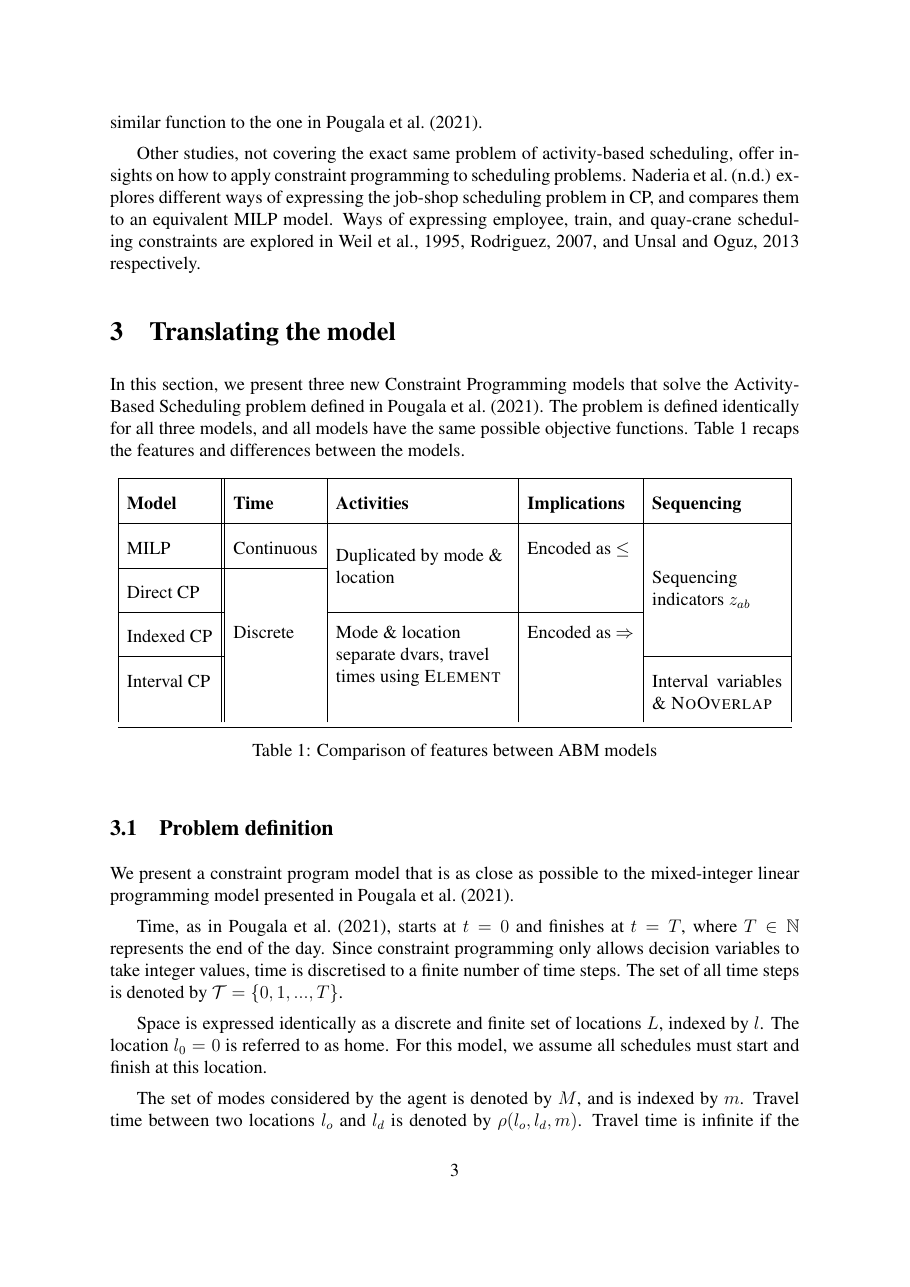
Abbiamo co-supervisionato tre varianti CP del MILP di Pougala et al. (2021), tutte implementate nel solver CP-SAT di Google OR-Tools e confrontate direttamente con il MILP originale. Nelle versioni CP il tempo è discretizzato (la CP richiede variabili decisionali intere), mentre il MILP mantiene il tempo continuo.
Variante 1, traduzione diretta in CP: un porting quasi meccanico del MILP. Stesso schema di duplicazione delle attività (una variabile decisionale per ogni terna attività × modo × luogo, con indicatori di sequenza z_ab e α_a^car per la coerenza del modo nei giri). Le implicazioni sono scritte come vincoli CP nativi invece di essere linearizzate con big-M. Serve da baseline: «che cosa offre la CP gratuitamente?».
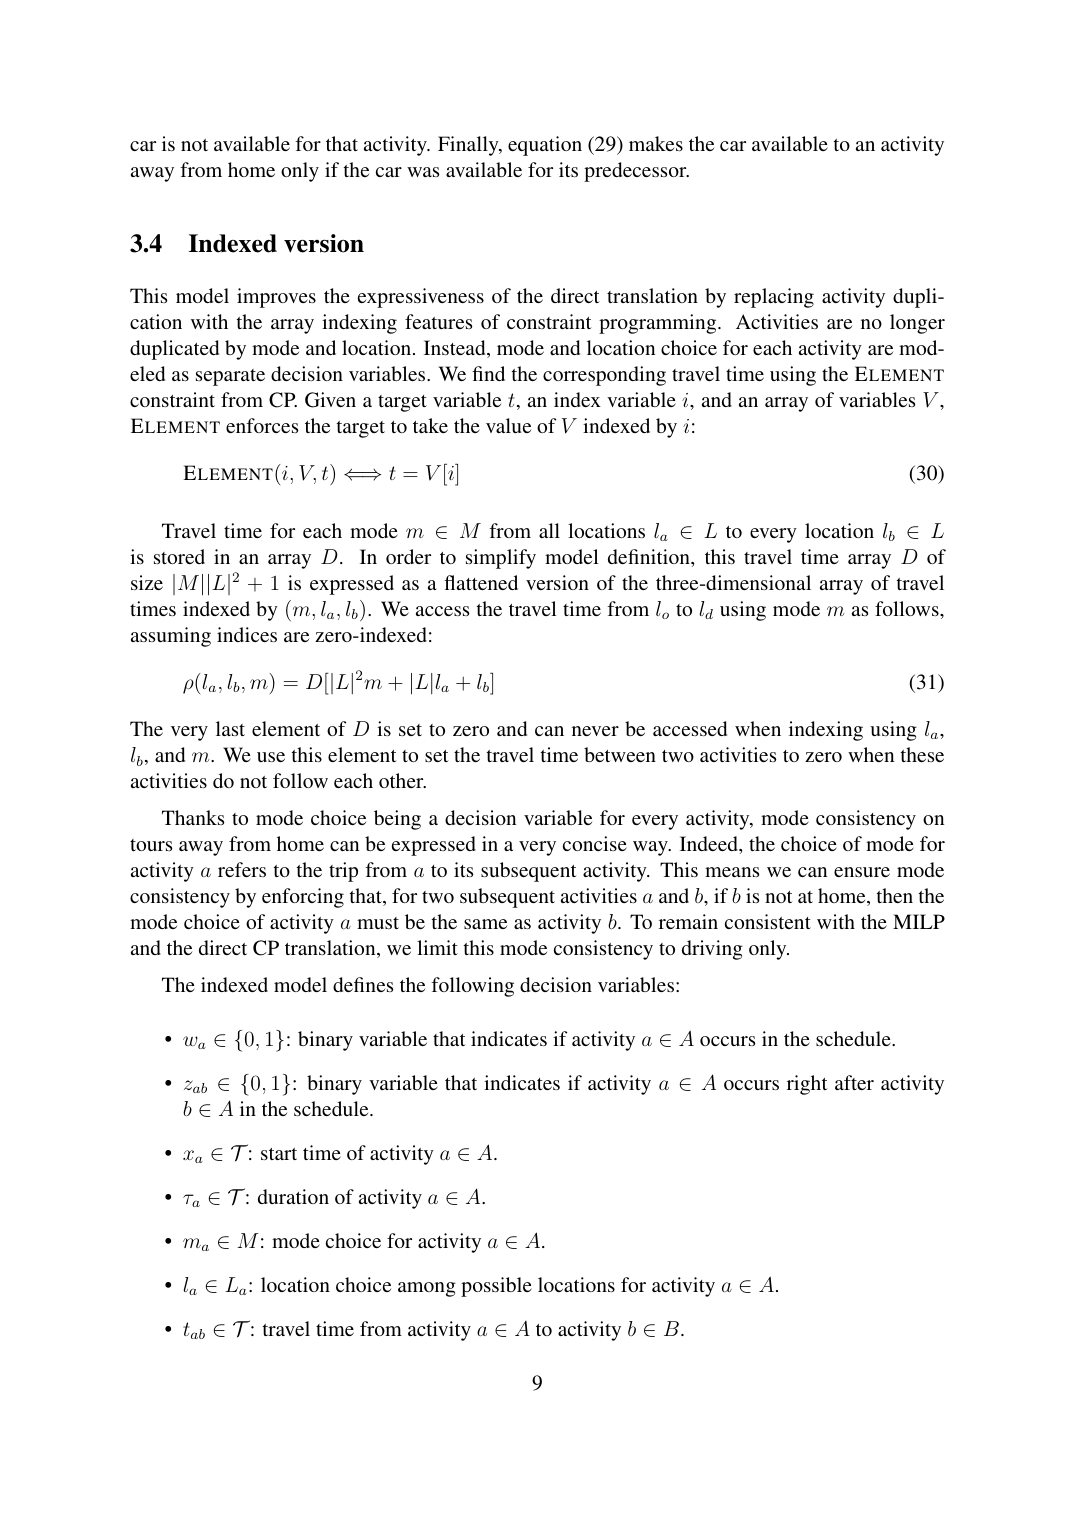
Variante 2, CP indicizzata: sostituisce la duplicazione delle attività con l'indicizzazione di array. Modo m_a e luogo l_a diventano variabili decisionali per ciascuna attività (invece di avere una copia separata di ogni attività per ogni combinazione); il tempo di percorrenza si ricava tramite il vincolo globale ELEMENT su un array appiattito D di dimensione |M| × |L|². La coerenza del modo diventa un'implicazione pulita su due righe. È la versione vincente.
Variante 3, CP a intervalli: aggiunge le variabili intervallo di CP-SAT I(x_a, Θ_a, y_a, ω_a) con NO_OVERLAP su tutte le attività. In teoria dovrebbe aiutare: lo scheduling a intervalli è un caso d'uso di punta di CP-SAT. In pratica non è così, perché il vincolo di coerenza temporale esistente (z_ab ⟹ x_a + τ_a + t_ab = x_b) fissa già le attività in sequenza, rendendo NO_OVERLAP un sovraccarico ridondante.
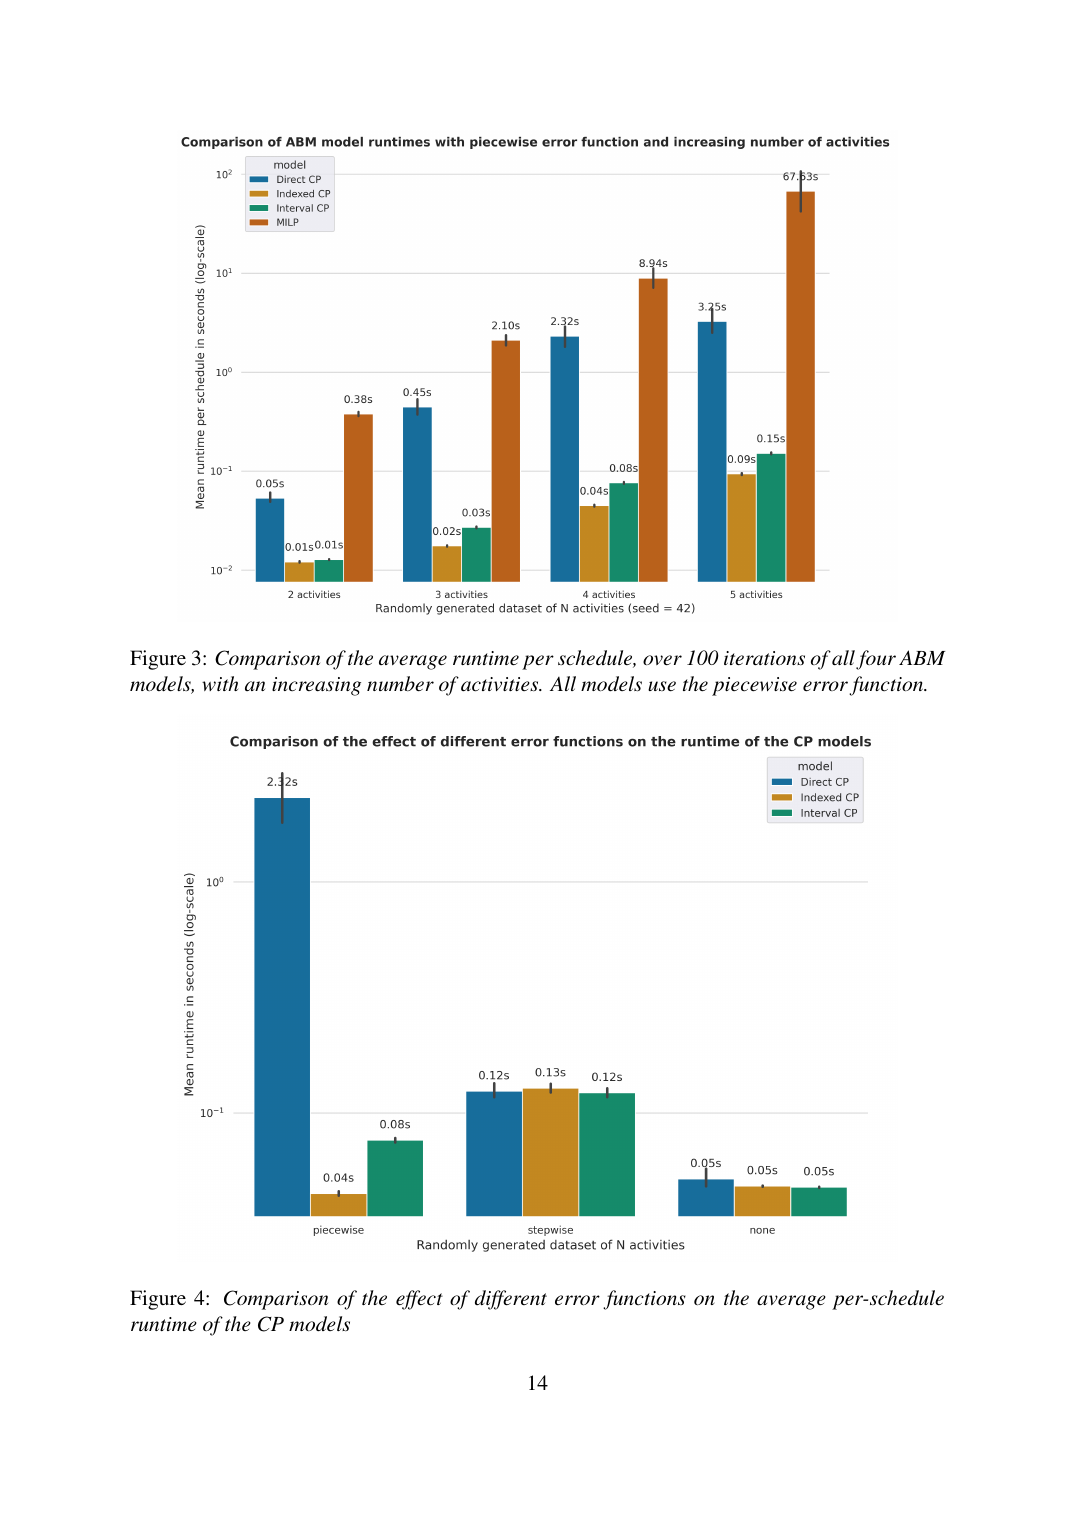
Tutte le varianti sono state confrontate su insiemi di attività generati casualmente, da RANDOM-2 a RANDOM-5 (da 2 a 5 attività distinte, con le attività di inizio e fine giornata, dawn e dusk, fissate). 100 iterazioni per ogni coppia (modello, istanza), con nuovi parametri d'errore a ogni iterazione e intervalli di confidenza bootstrap al 95 % sul tempo medio.
Il risultato
La variante CP indicizzata supera la baseline MILP di circa un ordine di grandezza sulle istanze a 2 attività e di quasi tre ordini di grandezza su quelle a 5 attività. Con 5 attività il MILP impiega 67,6 s, mentre la CP indicizzata impiega 0,09 s: un'accelerazione di 750×. La sola traduzione diretta in CP guadagna 20× sul MILP con 5 attività, a dimostrazione che qui anche un cambio di paradigma meccanico ripaga.
Il deliverable è più di un tempo di calcolo: è una metodologia per scegliere il paradigma giusto per ciascuna classe di problemi, insieme a un chiaro risultato negativo (le variabili intervallo non aiutano) che evita al team di promettere troppo, in futuro, sulle funzionalità a intervalli di CP-SAT per problemi simili.
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
Il problema di scheduling basato sulle attività di Pougala et al. (2021) genera il programma giornaliero di un individuo: scegliere quali attività svolgere, in quale ordine, a che ora iniziarle, per quanto tempo, in quale luogo e con quale modo di trasporto, in modo da massimizzare una funzione di utilità che penalizza gli scostamenti dal programma desiderato dall'individuo (penalità per inizio anticipato/ritardato, per durata più breve/più lunga, per tempo di percorrenza). Ciascuna delle tre varianti CP seguenti codifica lo stesso problema di ottimizzazione; le differenze stanno nel modo in cui ogni variante esprime la duplicazione delle attività e la logica degli intervalli.
Obiettivo di utilità condiviso. I termini di penalità deterministici V dipendono dai parametri di flessibilità di ciascuna attività, ossia da quanto l'individuo è disposto a iniziare prima/dopo o a svolgere attività più brevi/più lunghe. I termini stocastici U sono errori Gumbel(0, 1) (per la preferenza generica U a livello di programma) più funzioni d'errore per attività su durata, orario di inizio, modo e sequenza. Tutte e quattro le varianti CP e il MILP ottimizzano lo stesso obiettivo; le uniche differenze stanno nel modo in cui codificano i vincoli di ammissibilità che seguono.
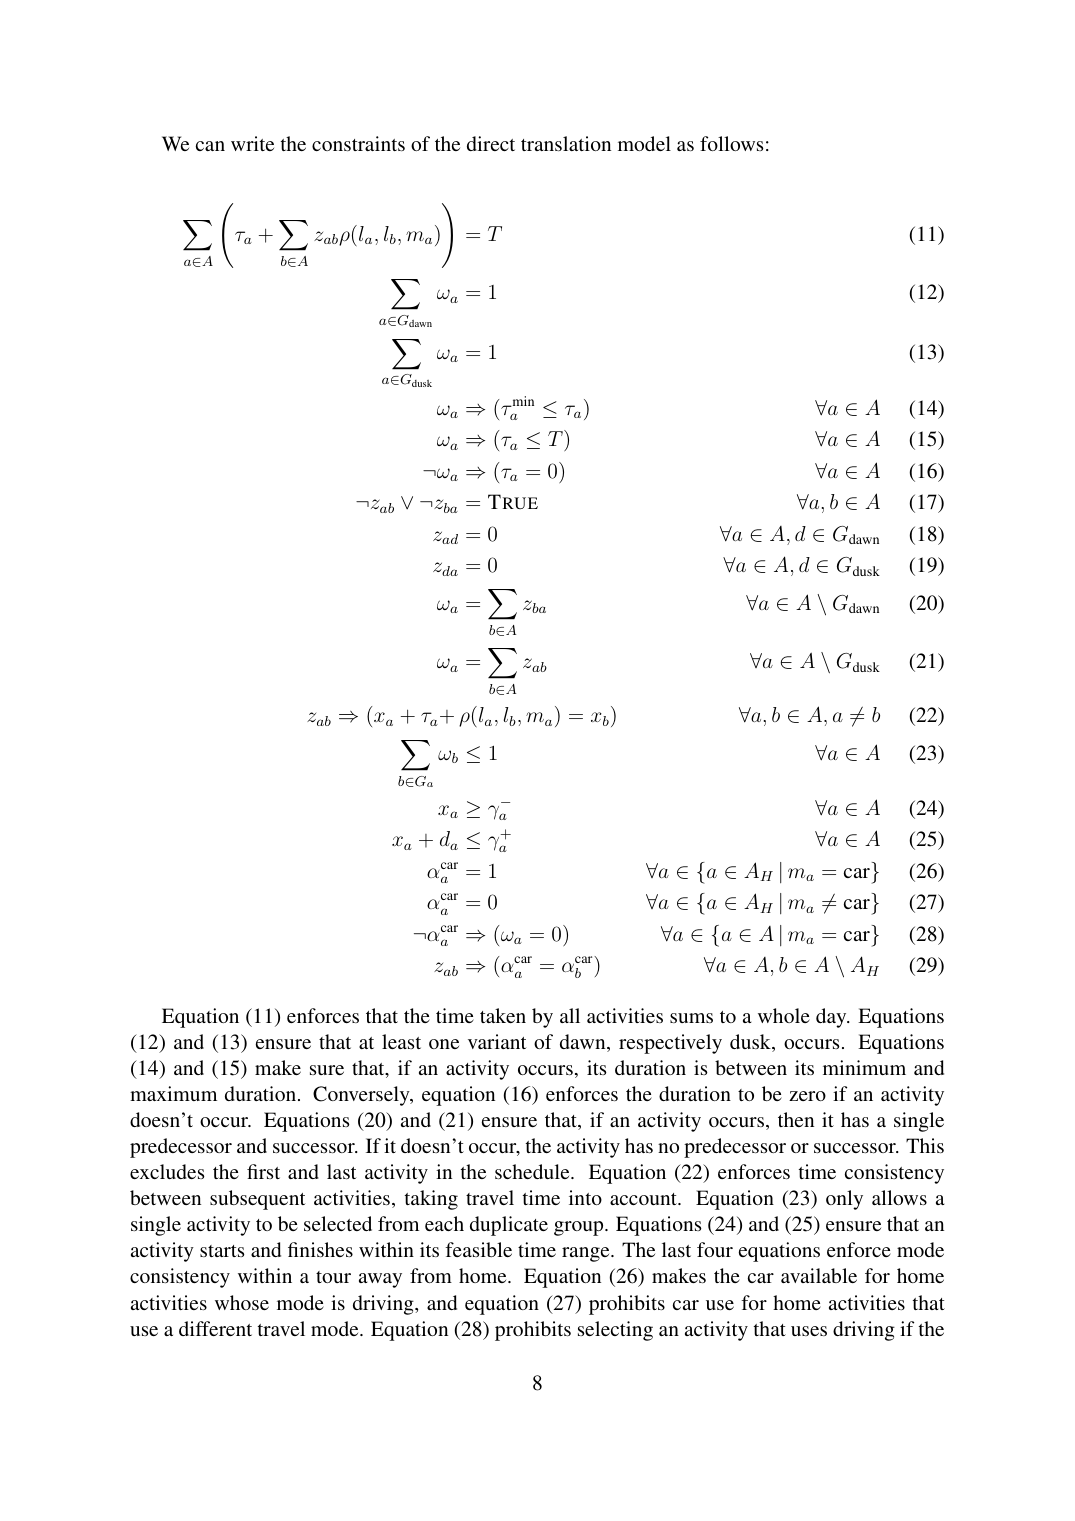
Somma sull'intera giornata e sequenza. Il tempo totale dedicato alle attività più gli spostamenti tra un'attività e l'altra deve essere pari alla durata della giornata T. L'implicazione z_ab ⟹ (x_a + τ_a + ρ = x_b) è il vincolo chiave che propaga l'informazione sugli orari di inizio lungo la sequenza scelta. Nel MILP viene linearizzata con big-M in due vincoli ≤; in CP è un'unica implicazione nativa che il propagatore di CP-SAT gestisce direttamente, ed è da qui che deriva una parte consistente dell'accelerazione.
Traduzione diretta: si mantiene il trucco della duplicazione delle attività del MILP. Ogni combinazione (luogo, modo) di un'attività è una variabile decisionale separata, con il vincolo di gruppo Σ ω_b ≤ 1 che impone che solo una copia di ciascuna attività entri nel programma. Ciò gonfia |A| di un fattore fino a |L_a| × |M|. La CP diretta è 20× più veloce del MILP con 5 attività solo grazie alla migliore gestione dei vincoli di implicazione da parte di CP-SAT, senza alcun cambiamento strutturale.
Riformulazione indicizzata: smettere di duplicare, iniziare a indicizzare. Modo m_a e luogo l_a diventano variabili decisionali per ciascuna attività (nessuna duplicazione). I tempi di percorrenza per tutte le combinazioni (modo, origine, destinazione) sono memorizzati in un array appiattito D di dimensione |M| × |L|² + 1. Il vincolo globale ELEMENT impone t_ab = D[i_ab], dove i_ab è l'indice calcolato in D. È questo il cambiamento strutturale che fa guadagnare l'ordine di grandezza aggiuntivo: il propagatore ELEMENT di CP-SAT è più incisivo di ciò che la versione diretta riesce a sfruttare.
Coerenza del modo nei giri lontano da casa. Eliminata la duplicazione delle attività (versione indicizzata), la regola «se si è presa l'auto per l'attività a e b non è a casa, l'auto deve essere ancora disponibile all'attività b» diventa due implicazioni pulite invece dei contorti vincoli condizionali big-M del MILP. È un esempio rappresentativo: ogni regola che il MILP codifica tramite z_ab × variabili continue diventa un'implicazione CP di una sola riga.
Variabili intervallo con NO_OVERLAP. Aggiunge intervalli opzionali (attivi solo quando ω_a = 1) e il vincolo globale NO_OVERLAP di CP-SAT, il modo canonico per esprimere in CP-SAT che «due attività non si svolgono contemporaneamente». Il risultato negativo: questa versione è 1,5–2× più lenta di quella indicizzata, perché l'implicazione di coerenza temporale esistente z_ab ⟹ (x_a + τ_a + t_ab = x_b) fissa già ogni attività nella sequenza, rendendo NO_OVERLAP ridondante. Il vincolo è tecnicamente valido ma attivamente dannoso: costringe CP-SAT a tenere traccia di più stato senza abilitare nuova propagazione.
Scalabilità. Il tempo di calcolo del MILP cresce di ~10× per ogni attività aggiunta (0,38 s → 67,6 s da N=2 a N=5). La CP indicizzata cresce solo di un fattore 9 sull'intero intervallo (0,01 s → 0,09 s), con un vantaggio di 750× per N=5. Il vantaggio si amplifica: la questione più profonda sollevata nelle conclusioni è se il divario dipenda interamente dal paradigma (propagazione CP vs branch-and-bound) o in parte dalla discretizzazione del tempo (la CP impone un tempo intero, il che riduce lo spazio decisionale). Il team la segnala come domanda di ricerca futura, ed è rilevante: se l'accelerazione derivasse soprattutto dalla discretizzazione, il MILP potrebbe colmare parte del divario con una propria discretizzazione.
Il risultato di punta è l'accelerazione di 750×, ma il risultato *interessante* è quello negativo sulle variabili intervallo. La combinazione intervalli + NO_OVERLAP di CP-SAT viene presentata come l'arma vincente per lo scheduling, e per il job-shop scheduling lo è senz'altro. Ma in questo problema di scheduling basato sulle attività l'implicazione di coerenza temporale esistente svolge già il lavoro che farebbe NO_OVERLAP, quindi aggiungere lo strato a intervalli è puro sovraccarico. Tre lezioni per il lavoro con i clienti: (1) la scelta del paradigma conta più della messa a punto dei parametri quando la struttura del problema si allinea ai punti di forza di un solver, (2) dopo il cambio di paradigma, le riscritture idiomatiche battono le traduzioni dirette di un ulteriore ordine di grandezza, (3) le funzionalità vistose non sono gratuite: a volte sono più lente della formulazione noiosa che già funziona.
Benchmark
Tempo medio di risoluzione per programma giornaliero su dataset di attività generati casualmente (da RANDOM-2 a RANDOM-5), 100 iterazioni per ogni coppia (modello, dataset) con nuovi parametri d'errore a ogni iterazione, funzione d'errore a tratti nell'obiettivo. Tempi in secondi. Tutti e quattro i modelli producono programmi di qualità comparabile (valori obiettivo entro il rumore): le differenze riguardano unicamente il tempo di calcolo.
| N. attività | MILP | CP diretta | CP indicizzata | CP a intervalli | Accelerazione indicizzata / MILP |
|---|---|---|---|---|---|
| 2 | 0,38 s | 0,05 s | 0,01 s | 0,01 s | 38× |
| 3 | 2,10 s | 0,45 s | 0,02 s | 0,03 s | 105× |
| 4 | 8,94 s | 2,32 s | 0,04 s | 0,08 s | 224× |
| 5 | 67,6 s | 3,25 s | 0,09 s | 0,15 s | 751× |
Il MILP scala di ~10× per ogni attività aggiunta: una classica esplosione del branch-and-bound man mano che l'albero decisionale cresce. La traduzione diretta in CP si appiattisce dopo 3 attività (beneficia del motore di propagazione di CP-SAT, ma eredita l'appesantimento dovuto alla duplicazione delle attività). La CP indicizzata ottiene una scalabilità quasi piatta: 0,01 → 0,09 s sull'intero intervallo, una crescita di 9× per 2,5× attività in più. La CP a intervalli è sistematicamente 1,5–2× più lenta di quella indicizzata: il risultato negativo. Il divario tra i dataset si allarga rapidamente: da 38× sull'istanza più piccola a 751× sulla più grande. Su un asse distinto (complessità della funzione obiettivo), la funzione d'errore a tratti evidenzia il divario più ampio all'interno della CP: diretta = 2,32 s vs indicizzata = 0,04 s vs a intervalli = 0,08 s con N = 5. Con la funzione d'errore nulla o a gradini, tutte le varianti CP terminano in ~0,05–0,12 s: il vantaggio di complessità della versione indicizzata si concretizza solo con forme dell'obiettivo realistiche.
Dalla documentazione
Tecniche
- Programmazione a vincoli con CP-SAT
- Programmazione intera mista (baseline MILP)
- Vincolo globale ELEMENT
- Vincoli di implicazione come oggetti di prima classe
- Variabili intervallo opzionali + NO_OVERLAP
- Discretizzazione del tempo per la compatibilità con la CP
Stack
- Python
- Google OR-Tools CP-SAT
- CPLEX (baseline MILP)
- MILP di Pougala et al. 2021
Un problema simile?