
← Ambiti di competenza/Revenue Management · 2025
Pricing esatto basato sulle scelte, fino a 1,67 milioni di volte più veloce della baseline MILP
Un algoritmo Branch-and-Benders spaziale + un Breakpoint Exact Algorithm in tempo polinomiale che risolve 1'000'000 scenari di domanda in 77 secondi e batte di 300× il precedente stato dell'arte specifico per il mixed logit (CoBiT)
1,67 × 10⁶ ×
accelerazione rispetto al MILP su Gurobi nell'ottimizzazione di un solo prezzo con R = 5'000 scenari
1'000'000
scenari di domanda risolti in 77 secondi dal Breakpoint Exact Algorithm
300×
più veloce di CoBiT, il precedente stato dell'arte per il pricing specifico per il mixed logit
OR Spectrum
sottoposto a peer review e pubblicato, Haering et al. 2024
Il pricing con modelli di domanda moderni (mixed logit, nested logit, qualunque cosa più ricca di un foglio di calcolo da corso base di vendite) è stato per decenni un vicolo cieco algoritmico. La formulazione MILP da manuale cede già oltre due prezzi. Lo stato dell'arte aveva ammesso che una soluzione «esatta» fosse semplicemente fuori portata.
Il nostro lavoro ha cambiato le cose. Pubblicati su OR Spectrum, la nostra Branch-and-Benders Decomposition spaziale e il Breakpoint Exact Algorithm battono il solver MILP di Gurobi di ordini di grandezza, e il nostro risultato di complessità fornisce uno schema polinomiale nel numero di clienti e di estrazioni.
Il problema
Il pricing basato sulle scelte, ossia fissare i prezzi che massimizzano il ricavo quando la domanda è generata da un modello di scelta discreta derivato dalla teoria dell'utilità aleatoria, è fondamentale per compagnie aeree, hotel, commercio al dettaglio e gestori di parcheggi. Eppure la formulazione esatta esistente, il MILP basato sulla simulazione di Paneque et al. (2021), cresce in modo esponenziale con il numero di estrazioni.
I solver standard arrancano non appena si superano dimensioni banali; le euristiche specializzate funzionano solo per specifiche di domanda ristrette. Non esisteva un algoritmo esatto e generale per questo problema.
Cosa abbiamo costruito
Abbiamo riformulato il MILP canonico in un programma quadratico non convesso con vincoli quadratici e funzione obiettivo lineare (QCQP-L), facendo emergere una struttura che il MILP nasconde. Abbiamo poi progettato un Branch-and-Bound spaziale su misura che usa gli inviluppi di McCormick per ottenere rilassamenti stretti e ramifica sulla violazione massima anziché sul lato più lungo.
Abbiamo accelerato ogni nodo del B&B con la decomposizione di Benders, così la parte costosa del rilassamento viene risolta con una sequenza di sottoproblemi poco onerosi invece che con un unico LP monolitico. L'intera pipeline è ciò che chiamiamo B&BD, Branch-and-Benders Decomposition spaziale.
Abbiamo poi sfruttato la struttura costante a tratti delle probabilità di scelta lungo l'asse dei prezzi per sviluppare il Breakpoint Exact Algorithm (BEA), la cui complessità è polinomiale nel numero di clienti e di estrazioni di simulazione (ed esponenziale solo nel numero di prodotti da prezzare), il che lo rende l'algoritmo d'elezione quando la dimensione dei prezzi è piccola.
Il risultato
Deliverable: tre algoritmi esatti per il pricing continuo basato sulle scelte con qualsiasi DCM a utilità lineare nel prezzo (mixed logit, nested logit, probit, paired combinatorial logit, tutta la famiglia), più un benchmark completo sul caso di studio dei parcheggi di Ibeas et al. (2014) con domanda mixed logit. Il Breakpoint Exact Algorithm risolve 1'000'000 scenari di domanda in 77 secondi, mentre Gurobi sulla riformulazione QCQP-L impiega 83'651 secondi con appena R = 5'000 scenari — un'accelerazione di 1,67 milioni di volte. Le varianti Branch-and-Bound e Branch-and-Benders prevalgono quando si ottimizzano tre o più prezzi contemporaneamente, con un'accelerazione fino a 20× rispetto a Gurobi con quattro prezzi.
Rispetto a CoBiT (Marandi e Lurkin 2023), lo stato dell'arte pubblicato per il pricing specifico per il mixed logit, i nostri metodi sono in media 42× più veloci (B&B), 8× più veloci (B&BD) e 300× più veloci (BEA) sulle istanze a due prezzi. CoBiT è costruito su misura per il mixed logit; i nostri metodi funzionano con qualsiasi DCM a utilità lineare nel prezzo — e la maggiore generalità non costa tempo di calcolo, anzi ne fa guadagnare. Pubblicato su OR Spectrum, Haering et al. 2024.
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
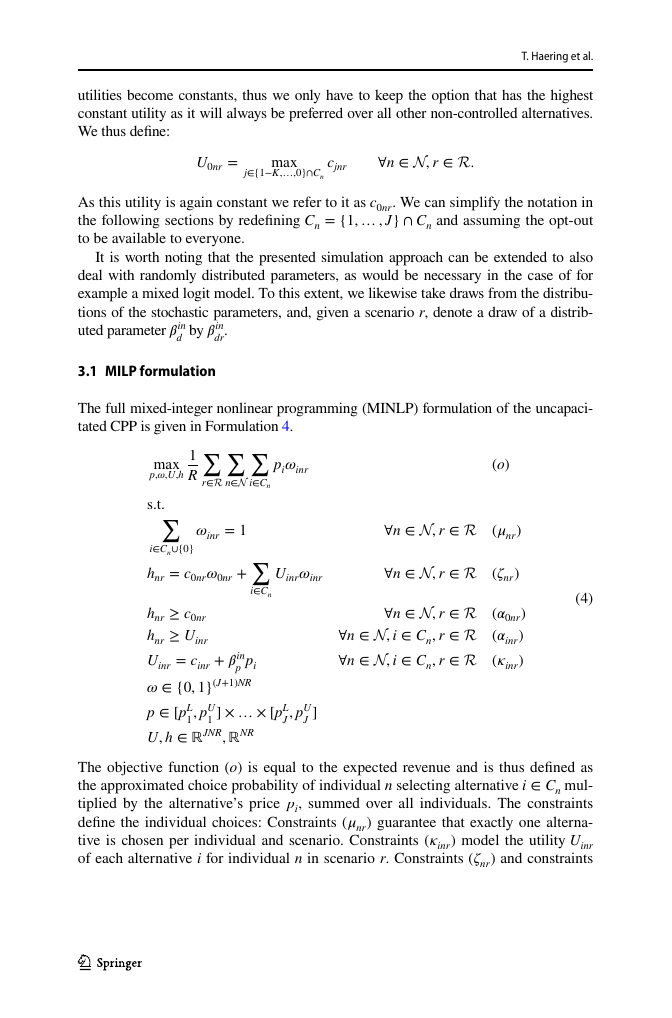
Il problema consiste nel fissare J prezzi controllati per massimizzare il ricavo atteso quando N clienti scelgono tra J + K alternative, con una domanda derivata dalla teoria dell'utilità aleatoria. Per i DCM moderni (mixed logit, probit, nested logit) le probabilità di scelta non hanno forma chiusa, perciò Paneque et al. (2021) le hanno approssimate estraendo R scenari Monte Carlo dei termini di errore, congelando ogni estrazione in un'utilità deterministica e scrivendo un gigantesco MILP basato sulla simulazione. Il punto debole: ogni tupla (i, n, r) introduce un prodotto bilineare pᵢ ωᵢₙᵣ tra il prezzo e l'indicatore binario di scelta, che il MILP linearizza con variabili ausiliarie big-M, e il modello esplode in modo esponenziale in R. La nostra catena di riformulazioni elimina questa struttura.
Framework di simulazione. Per ogni estrazione Monte Carlo r ∈ {1, …, R}, l'utilità del cliente n per il prodotto i è una costante deterministica c_inr più un termine lineare nel prezzo β_p · p_i. La variabile di scelta ω_inr vale 1 se e solo se il prodotto i realizza l'arg-max per quella coppia (n, r). La media di ω sulle R estrazioni fornisce uno stimatore non distorto della vera probabilità di scelta, che converge alla domanda ML/probit/NL sottostante per R → ∞.
Il MILP di Paneque et al. (formulazione 4). La funzione obiettivo è il ricavo atteso. I vincoli impongono che le variabili di scelta ω risolvano, per ogni (n, r), un knapsack di massimizzazione dell'utilità, codificato tramite dualità forte (ammissibilità primale + ammissibilità duale + complementarità). I termini bilineari p_i · ω_inr nella funzione obiettivo sono linearizzati con variabili ausiliarie big-M η_inr: è questa linearizzazione a distruggere la totale unimodularità del knapsack e a far crescere il problema in modo esponenziale in R.
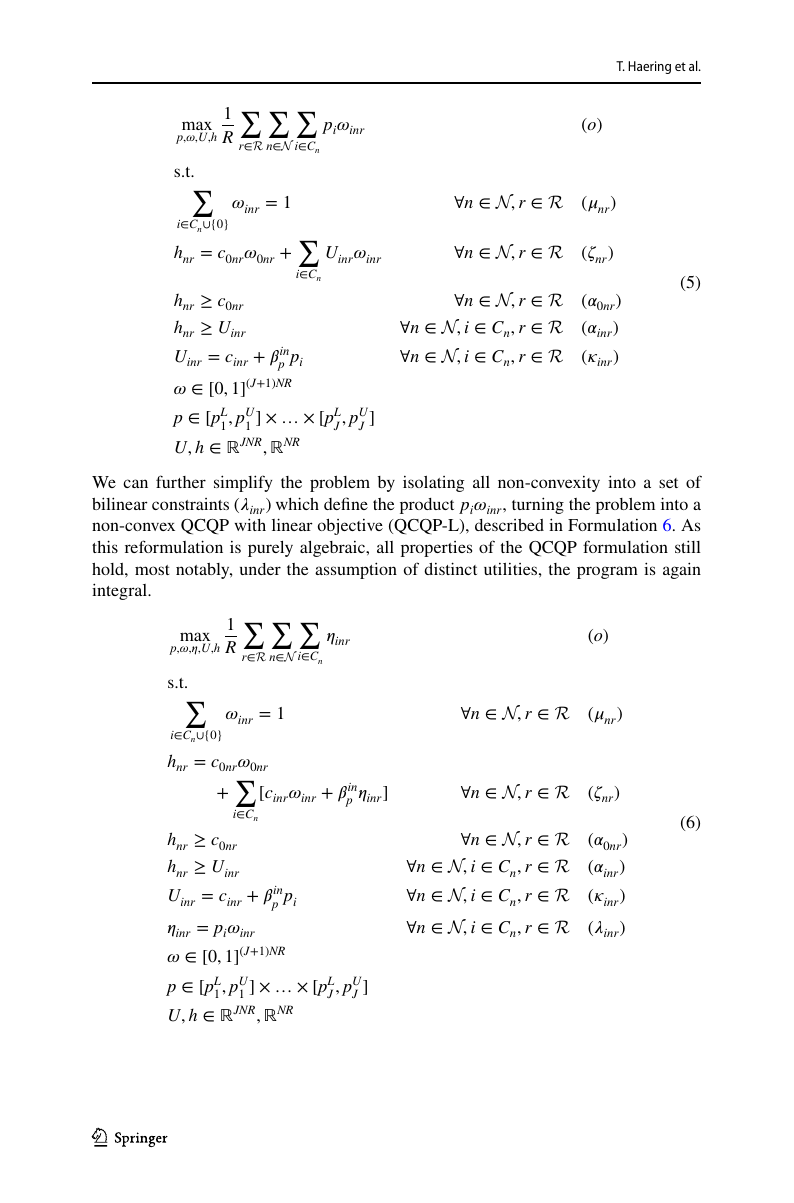
La nostra prima riformulazione. Rimuoviamo il vincolo di interezza su ω (il knapsack per ogni (n, r) è totalmente unimodulare, quindi il rilassamento LP è intero ogni volta che le utilità sono distinte) e manteniamo il termine bilineare η_inr = p_i ω_inr come uguaglianza quadratica esplicita non convessa. Risultato: un QCQP non convesso con funzione obiettivo lineare. Tutta la non convessità è ora isolata in un unico blocco di vincoli bilineari; il resto del modello è lineare.
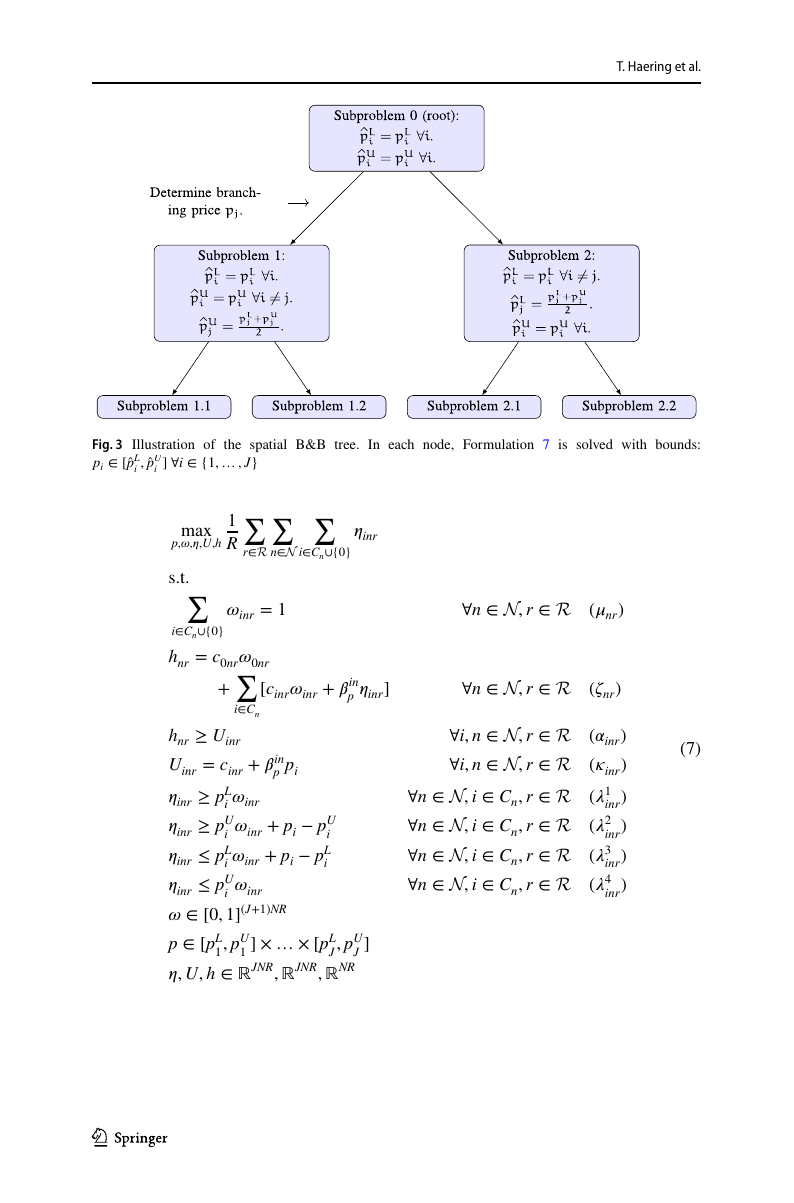
Inviluppo di McCormick. Ogni uguaglianza bilineare η_inr = p_i ω_inr viene sostituita da quattro disuguaglianze lineari valide sul box corrente [p_i^L, p_i^U] × [0, 1]. È il rilassamento convesso lineare più stretto del termine bilineare, tanto più stretto quanto più il box si restringe. L'LP risultante (formulazione 7) fornisce un limite superiore al ricavo del QCQP-L in ogni nodo del B&B.
Regola di branching su misura. Invece del branching sul lato più lungo (il B&B spaziale da manuale), ramifichiamo sul prezzo il cui vincolo bilineare è in media più violato su (n, r) nella soluzione del rilassamento corrente. Empiricamente questa regola domina il branching sul lato più lungo, quello pesato per quota di mercato e quello casuale in tutte le classi di istanze testate. Ramifichiamo solo sulle J variabili di prezzo, mai sulle JNR variabili η o ω, il che riduce l'albero di ricerca di ordini di grandezza rispetto a ciò che fa Gurobi sul QCQP-L grezzo.
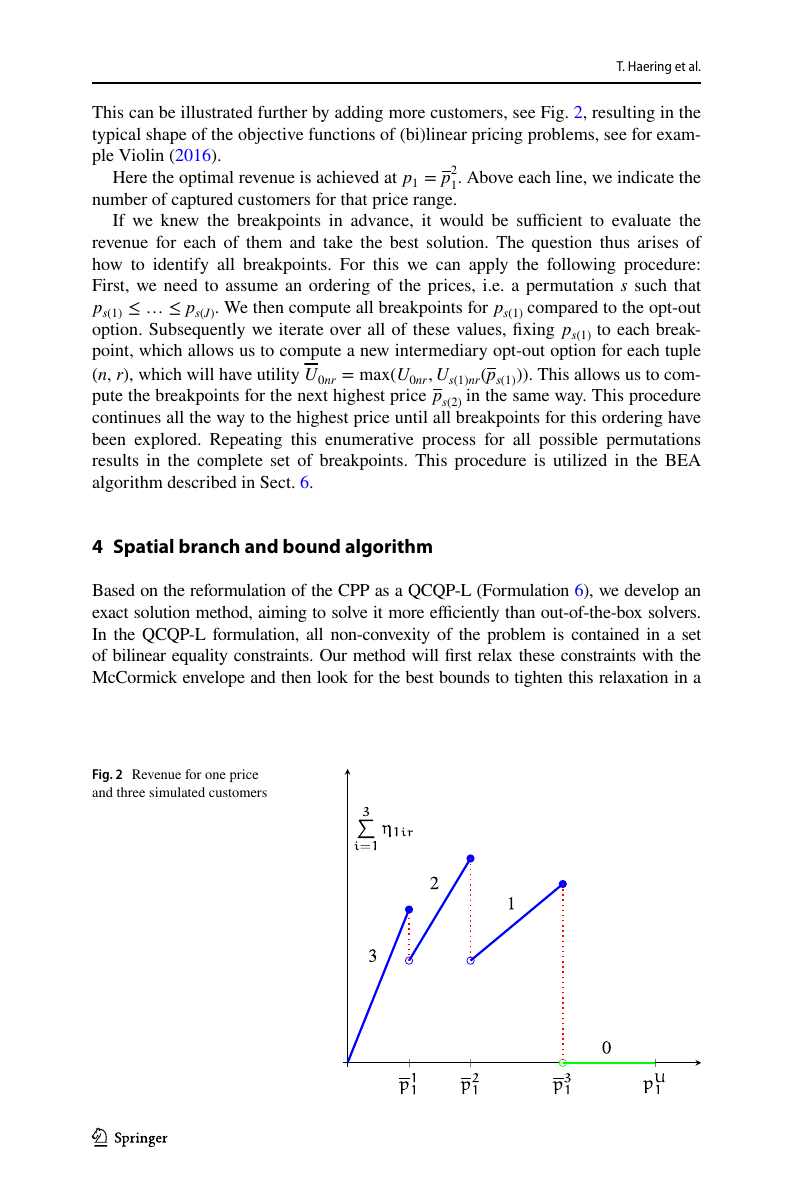
Struttura dei breakpoint. In corrispondenza di qualsiasi prezzo ottimo p_i*, un cliente n in uno scenario r deve essere esattamente indifferente tra l'alternativa i e la migliore opzione successiva; altrimenti potremmo aumentare p_i di ε senza perdere nessuno. Risolvendo l'equazione di indifferenza si ottengono al massimo NR + 2 prezzi candidati per prodotto (estremi del box inclusi). L'enumerazione sui J prodotti genera l'albero di ricerca esplorato dal BEA.
Complessità del BEA. Il primo algoritmo polinomiale nel numero di clienti e di estrazioni per il problema di pricing basato sulle scelte. Con uno o due prodotti da prezzare è drasticamente più veloce di qualsiasi branch-and-bound: il BEA ha risolto il problema a un solo prezzo con un milione di estrazioni in 77 secondi, mentre la formulazione QCQP-L su Gurobi ha raggiunto il limite di tempo a 7'000 estrazioni dopo un giorno intero. Con tre o più prodotti da prezzare, la J all'esponente fa esplodere il BEA e l'approccio B&B / B&BD ha la meglio.
Tre algoritmi, un solo articolo. Il B&B spaziale con branching su misura batte Gurobi sul MILP e Gurobi sul QCQP-L di un buon ordine di grandezza. Aggiungere la decomposizione di Benders in ogni nodo (B&BD) proietta fuori le JNR variabili η e ω, il che conta tanto più quanto più grande è l'istanza: il B&BD supera il B&B semplice a 500 estrazioni con quattro prezzi, a 1'000 estrazioni con due prezzi e a 3'000 estrazioni con un solo prezzo. Il BEA domina tutto per J ≤ 2, perché la struttura dei breakpoint è enumerabile; B&B / B&BD dominano per J ≥ 3, perché l'albero dei breakpoint è esponenziale in J. L'algoritmo giusto dipende dalla dimensione dei prezzi, e il nostro articolo rende esplicita la scelta, con il relativo risultato di complessità.
Benchmark
Ottimizzazione a due prezzi sul caso di studio dei parcheggi di Ibeas et al. (2014) (J = 2, N = 50 clienti, R = numero di estrazioni di simulazione variabile). Tutti i tempi in secondi, tolleranza di ottimalità dello 0,01 %, limite di tempo di 72 h, Gurobi 10.0.3 con tuning degli iperparametri. Tutti e cinque i metodi trovano gli stessi prezzi ottimi p₁ ≈ 0,56 e p₂ ≈ 0,67, con un ricavo ≈ 27,0.
| Estrazioni R | MILP (Paneque) | QCQP | QCQP-L | B&B (nostro) | B&BD (nostro) | BEA (nostro) |
|---|---|---|---|---|---|---|
| 200 | 9'042 | 4'195 | 3'403 | 1'386 | 3'015 | 11 |
| 300 | 42'804 | 9'503 | 7'951 | 2'998 | 5'418 | 24 |
| 400 | 112'335 | 22'567 | 19'283 | 6'378 | 11'858 | 41 |
| 500 | 242'877 | 32'886 | 25'030 | 7'963 | 12'064 | 69 |
Il MILP scala in modo catastrofico con il numero di estrazioni, da 2,5 ore con R = 200 a 67,5 ore con R = 500: un'esplosione dei tempi di 27× per 2,5× estrazioni in più. La riformulazione continua (QCQP, QCQP-L) guadagna già un fattore 5–9 eliminando il costo del big-M. Il nostro B&B spaziale con branching su misura batte il MILP di ~30× in tutti i casi; il B&BD cede parte di questo vantaggio in cambio di un overhead che ripaga solo su scala maggiore. Il BEA gioca in un'altra categoria: con R = 500 trova l'ottimo dimostrato in 69 secondi contro i 242'877 secondi del MILP, un'accelerazione di 3'520×. Il quadro diventa ancora più netto per R grandi: con 5'000 estrazioni il BEA risolve in 0,05 secondi, mentre il QCQP-L su Gurobi impiega 83'651 secondi (un fattore 1,6 × 10⁶); con 1'000'000 estrazioni il BEA termina comunque in 77 secondi.
Dalla documentazione
Tecniche
- Branch-and-Bound spaziale
- Decomposizione di Benders
- Rilassamenti con inviluppi di McCormick
- Enumerazione dei breakpoint
- Modellazione a utilità aleatoria / DCM
Stack
- Python
- Gurobi 10
- Julia (confronto con CoBiT)
- Stack di modellazione a scelta discreta
Un problema simile?