
← Ambiti di competenza/Scelta discreta · Stima · 2025
BHAMSLE: +17,2 % di log-verosimiglianza sulla mistura di scelta modale di Londra, in metà del tempo di Multistart Biogeme
Un Breakpoint Heuristic Algorithm per la stima di massima verosimiglianza simulata (MSLE) di modelli avanzati di scelta discreta — sfrutta la stessa struttura combinatoria alla base dei nostri algoritmi di pricing pubblicati su OR Spectrum
+17,2 %
di log-verosimiglianza sulla mistura discreto-continua di scelta modale di Londra
Metà del tempo
di Multistart Biogeme con M=20, il numero minimo di riavvii che eguaglia la soluzione di BHAMSLE
7,7×
più veloce di Multistart Biogeme con M=100, a parità di log-verosimiglianza finale
Ritrova i valori veri
ripartizione tra classi latenti (0,69; 0,31), dove Biogeme predefinito resta bloccato sulla ripartizione uniforme (0,50; 0,50)
Stimare i moderni modelli di scelta a classi latenti e a mistura discreto-continua è un incubo computazionale silenzioso. Centinaia di massimi locali, rumore di simulazione e superfici di verosimiglianza che somigliano alle Alpi. I solver standard trovano una vetta, di solito quella sbagliata.
Abbiamo preso la struttura a breakpoint (punti di rottura) scoperta per il pricing basato sulla scelta e l'abbiamo trasferita al problema di stima. Il risultato, BHAMSLE, trova log-verosimiglianze più alte, segmenti latenti più interpretabili e un recupero più fedele dei parametri veri rispetto a CMA-ES, allo stimatore esistente basato su MILP e persino a Biogeme multistart con 50 riavvii casuali.
Il problema
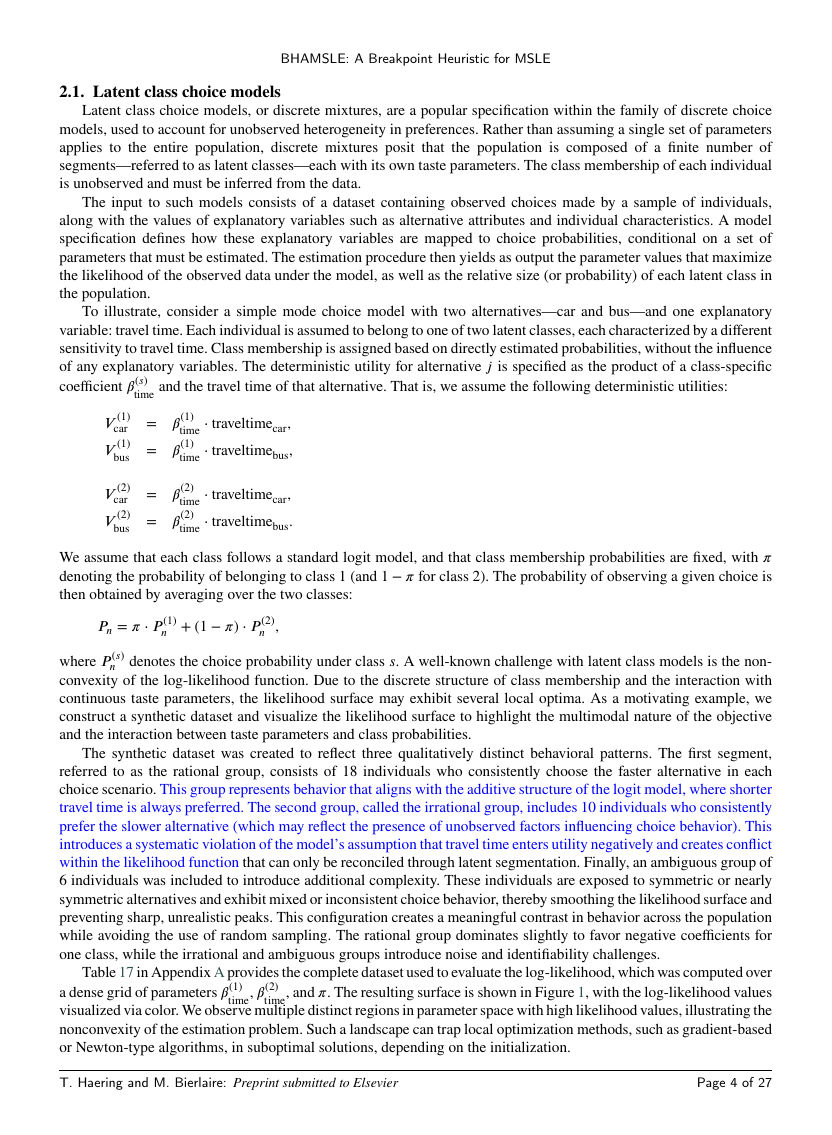
La stima di massima verosimiglianza simulata di DCM avanzati (modelli a classi latenti con misture continue, insiemi di scelta ristretti e specificazioni flessibili dell'utilità) è afflitta da multimodalità e da rumore indotto dalla simulazione. Anche la superficie di verosimiglianza di un semplice logit a due classi può presentare diversi bacini distinti ad alta verosimiglianza; gli stimatori di tipo Newton convergono verso quello che si trova più vicino al punto di partenza.
L'unico approccio della letteratura che sfrutta la struttura del problema è la riformulazione MILP di Fernández Antolín (2018), che in linea di principio garantisce l'ottimalità globale ma non scala oltre istanze minuscole. Le soluzioni di ripiego abituali tra i professionisti (multistart da inizializzazioni casuali, CMA-ES, PSO) pagano la multimodalità con la forza bruta e convergono regolarmente verso risultati privi di senso sul piano interpretativo (una classe con probabilità del 100 %, «distribuzioni» a varianza nulla, parametri di mistura collassati).
Cosa abbiamo costruito
Abbiamo osservato che la MSLE basata sulla simulazione condivide la stessa ossatura combinatoria del pricing basato sulla scelta: variabili indicatrici per individuo ω_inr che commutano in un numero finito di breakpoint dipendenti dai parametri, con la funzione obiettivo (qui la log-verosimiglianza, là il ricavo) costante a tratti tra una commutazione e l'altra.
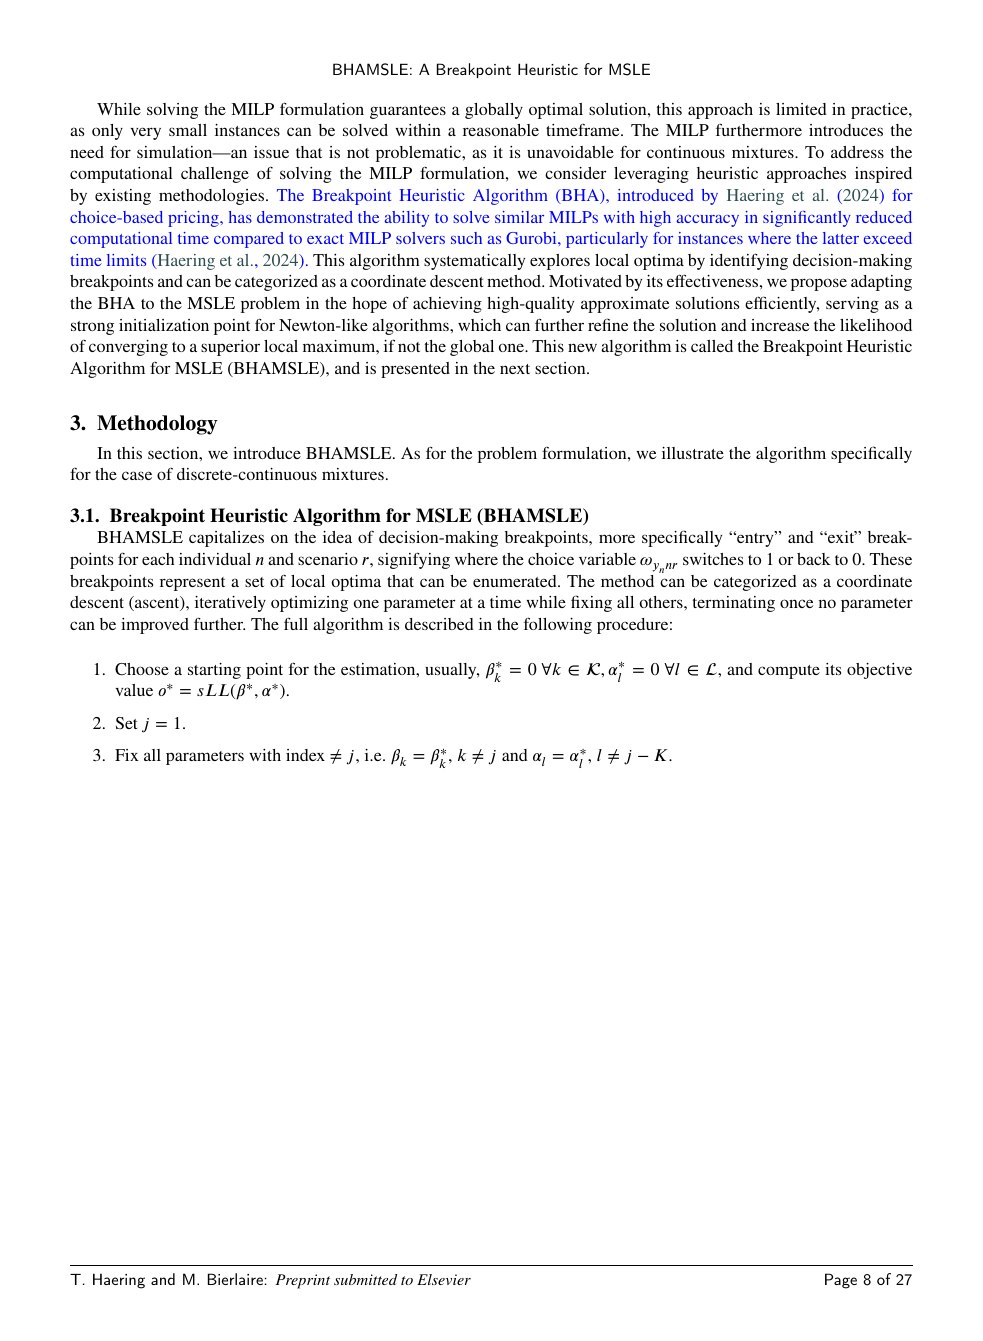
Su questa osservazione abbiamo costruito BHAMSLE: un algoritmo di ascesa per coordinate che percorre lo spazio dei parametri un breakpoint alla volta, valutando esattamente la log-verosimiglianza simulata a ogni commutazione e sfruttando una struttura che CMA-ES, PSO e i metodi del gradiente ignorano. Le due fonti di breakpoint sono trattate separatamente: i breakpoint dei parametri di utilità (dove ω commuta al variare di β, a parità di assegnazione alle classi) e i breakpoint delle funzioni di punteggio (dove è l'appartenenza stessa alla classe a commutare al variare di α o γ).
BHAMSLE non è pensato come stimatore finale, bensì come strategia di inizializzazione: inseritelo a monte della routine standard di tipo Newton di Biogeme e osservate la soluzione finale migliorare, con una ricerca che sfrutta la struttura e costa minuti anziché le ore richieste da Biogeme multistart.
Il risultato
Deliverable: BHAMSLE, uno schema di inizializzazione euristico basato sui breakpoint per la stima di massima verosimiglianza simulata di modelli avanzati di scelta discreta (classi latenti, misture continue, misture discreto-continue). Il metodo sfrutta la stessa struttura combinatoria alla base dei nostri algoritmi di pricing pubblicati su OR Spectrum, applicata qui alla log-verosimiglianza anziché al ricavo.
Sulla mistura discreto-continua di scelta modale di Londra (N = 500, R = 500), Biogeme inizializzato con BHAMSLE raggiunge LL = −243,68 contro −294,38 con l'inizializzazione predefinita, un miglioramento del 17,2 %, in 3,8 ore. Multistart Biogeme ha bisogno di 20 riavvii (7,4 ore, circa il doppio del tempo di BHAMSLE) per eguagliare questo risultato; con 100 riavvii impiega 7,7 volte il tempo di BHAMSLE per la stessa qualità finale. Nel test a classi latenti discrete, Biogeme inizializzato con BHAMSLE ritrova la vera ripartizione tra le classi (0,69; 0,31), mentre Biogeme predefinito resta bloccato sulla ripartizione uniforme (0,50; 0,50).
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
La stima di massima verosimiglianza simulata di un DCM avanzato ha una struttura fondamentalmente diversa dal logit dei manuali. Le probabilità di scelta non hanno forma chiusa (i modelli a mistura integrano su distribuzioni continue dei parametri di preferenza), quindi le approssimiamo con il metodo Monte Carlo. Questo introduce R scenari simulati per individuo e, per ogni valore dei parametri, ogni coppia (n, r) ha un indicatore deterministico «vince l'alternativa osservata» che si attiva o si disattiva a seconda che il parametro sia al di sopra o al di sotto di una soglia specifica per cliente e scenario. La struttura a breakpoint sfruttata da BHAMSLE è esattamente l'insieme dei valori dei parametri in cui avviene una di queste commutazioni.
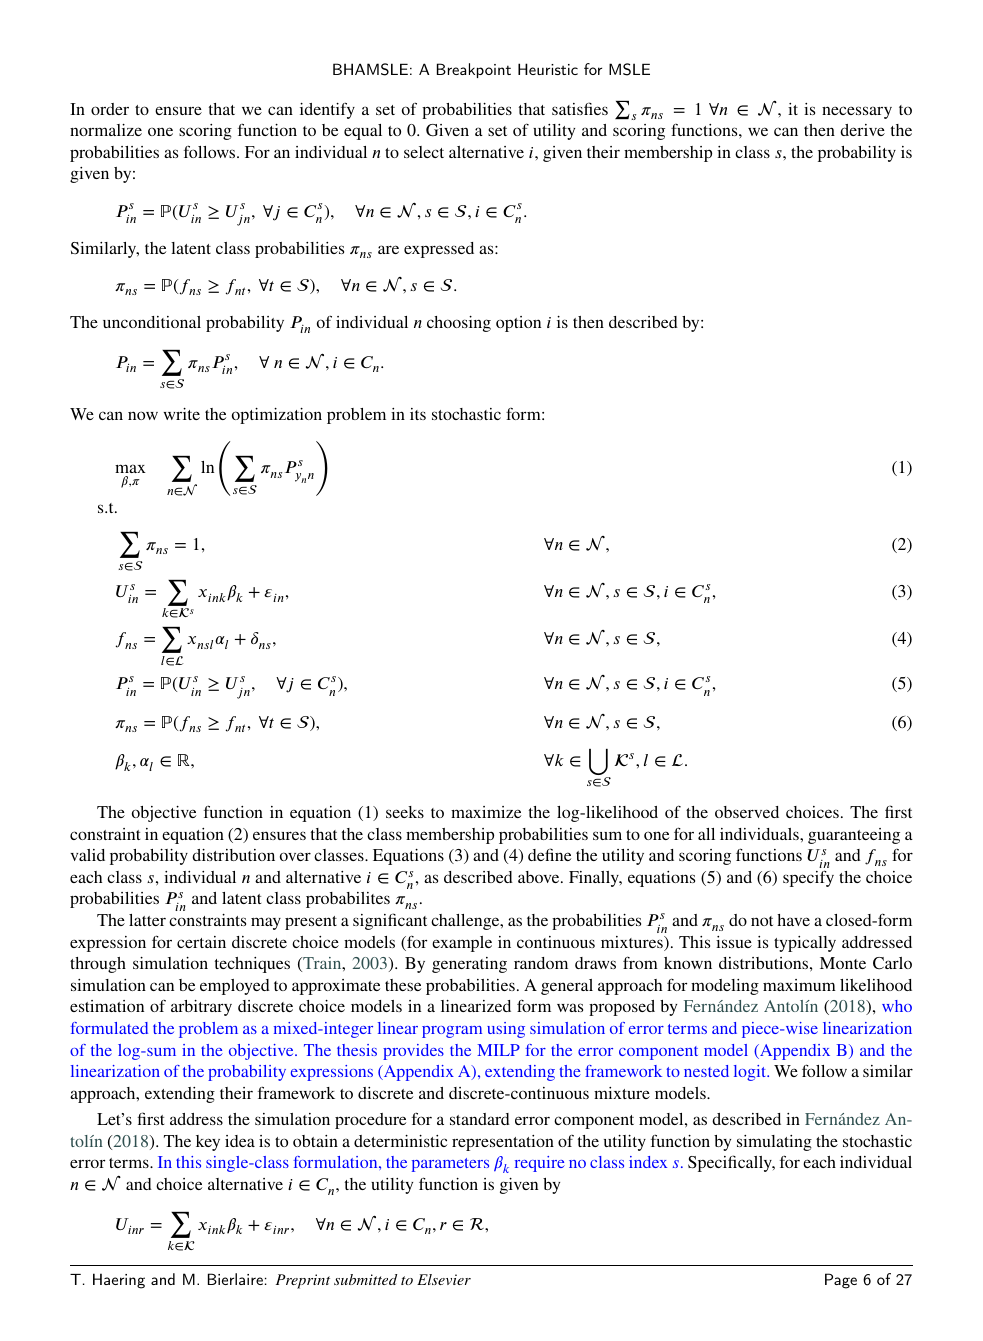
Il problema MSLE nella sua forma stocastica. Somma, sugli individui, del logaritmo di una media ponderata per probabilità delle probabilità di scelta per classe. Le variabili decisionali sono i coefficienti di utilità β (spesso dipendenti dalla classe) e le probabilità di appartenenza alle classi π. Per le misture continue, P^s_in è un integrale su una densità normale dei parametri di preferenza distribuiti: ecco perché serve la simulazione.
Schema di simulazione. Per ogni scenario r e individuo n, l'utilità dell'alternativa i nella classe s diventa deterministica una volta estratto il termine d'errore ε_inr. L'indicatore di scelta ω^s_inr vale 1 se e solo se i vince l'arg-max per quella terna (n, s, r). La media di ω sulle R estrazioni fornisce uno stimatore non distorto di P^s_in (Train 2003).
Log-verosimiglianza simulata dopo il Monte Carlo. Σ_n conta quanti degli R scenari selezionano l'alternativa osservata y_n per l'individuo n (secondo l'assegnazione alle classi di quello scenario). L'obiettivo è la somma dei log-Σ_n sugli individui, una funzione costante a tratti di β e π, che salta a ogni breakpoint in cui qualche ω commuta.
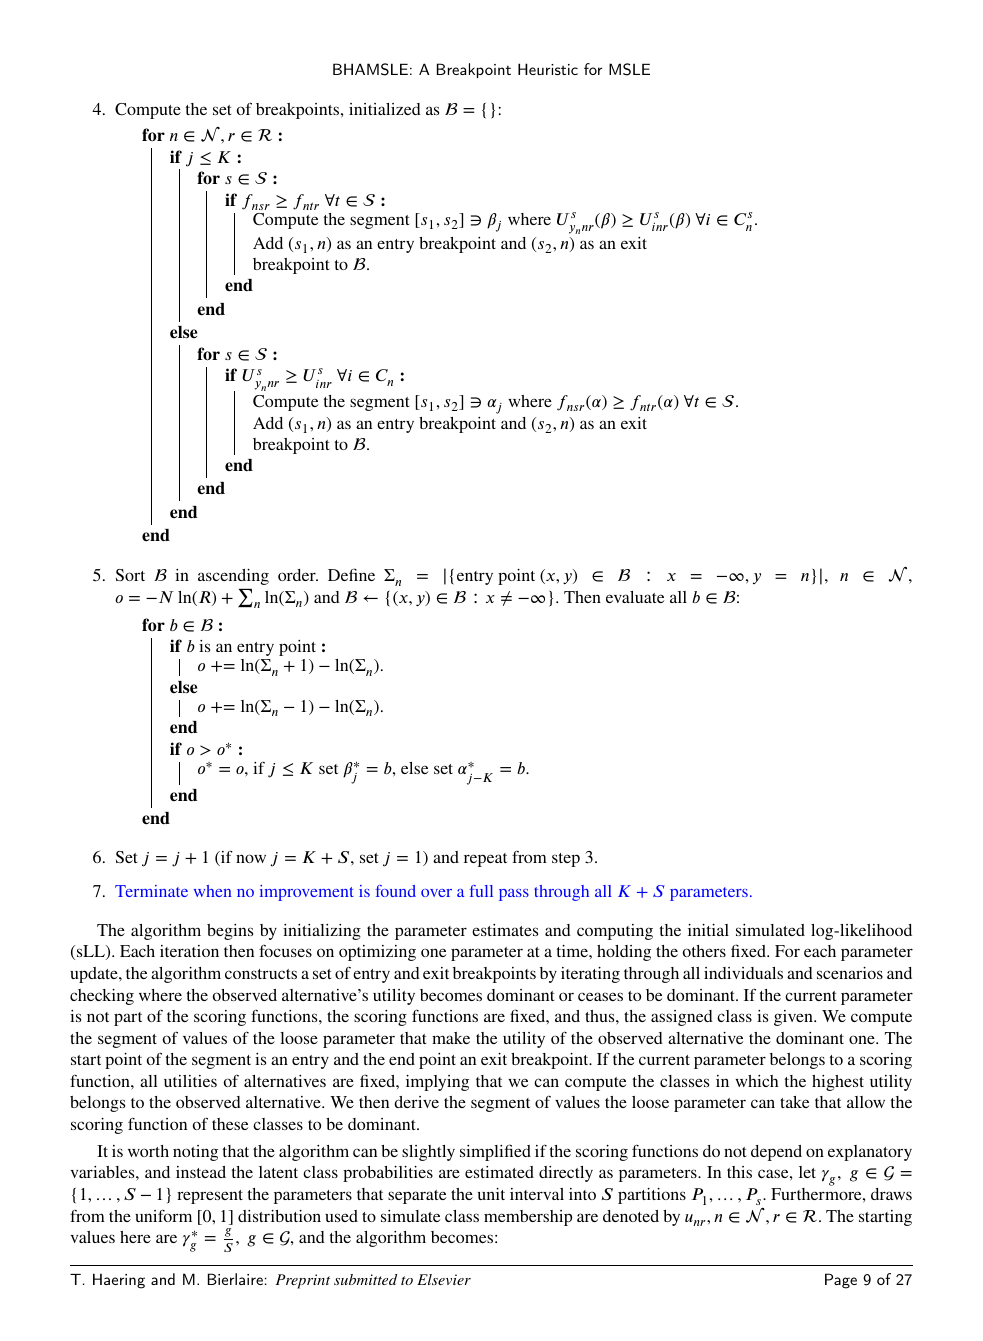
Costruzione dei breakpoint per un parametro di utilità β_j. Fissati tutti gli altri parametri, il segmento di β_j in cui l'alternativa osservata y_n resta dominante per l'individuo n nello scenario r e nella classe s è delimitato da due punti di indifferenza. L'estremo inferiore s_1 è un breakpoint di «entrata» (ω si attiva quando β_j lo supera crescendo); l'estremo superiore s_2 è un breakpoint di «uscita» (ω si disattiva). Su tutte le terne (n, r, s) si ottengono al massimo 2NRS breakpoint per parametro.
Aggiornamenti incrementali della log-verosimiglianza. Percorrendo i breakpoint in ordine lungo la j-esima coordinata, la variazione della log-verosimiglianza simulata in ciascuno di essi è semplicemente la differenza tra due logaritmi di conteggi: un costo O(1) per breakpoint, contro il costo O(NR) che un ottimizzatore black-box pagherebbe per rivalutare l'intero obiettivo. È questo che permette a BHAMSLE di scalare: un passaggio completo su una coordinata costa O(NRS) anziché l'O((NR)²) di una ricerca lineare ingenua.
Ciclo esterno di BHAMSLE. Ascesa per coordinate sui K parametri di utilità e sugli S − 1 parametri di probabilità di classe. A ogni passo fissiamo K + S − 2 parametri, enumeriamo i breakpoint della coordinata attiva e scegliamo quello che massimizza la log-verosimiglianza simulata. L'algoritmo termina quando un passaggio completo sulle K + S coordinate non produce miglioramenti superiori a τ = 10⁻⁶.
Confronto di complessità. C è il numero di cicli esterni di ascesa per coordinate (empiricamente < 20 sulle istanze di benchmark); il termine interno NRS corrisponde all'enumerazione dei breakpoint e all'aggiornamento incrementale. Multistart Biogeme deve pagare una convergenza Newton completa per ciascuno degli M riavvii, e M deve crescere con il numero di ottimi locali, che per le misture discreto-continue si conta a centinaia. Sulla mistura di Londra del Test 4, BHAMSLE eguaglia Multistart Biogeme con M = 20 in circa metà del tempo reale e supera M = 10.
Qui abbiamo preso un'osservazione strutturale da una classe di problemi completamente diversa, il pricing, e ci siamo accorti che si trasferisce alla stima, perché entrambi i problemi calcolano un obiettivo esterno su indicatori simulati di scelta discreta. La stessa enumerazione dei breakpoint che guidava BEA e BHA negli articoli sul pricing guida qui BHAMSLE, con due novità: (1) l'obiettivo contiene un logaritmo anziché una somma, per cui usiamo aggiornamenti incrementali dei logaritmi anziché addizioni, e (2) i parametri delle classi latenti compaiono all'interno di funzioni indicatrici dell'assegnazione alle classi, non della scelta dell'alternativa, e richiedono quindi una propria logica dei breakpoint. Il vantaggio è costante in tutti i test dell'articolo: Biogeme inizializzato con BHAMSLE trova log-verosimiglianze più alte dell'inizializzazione predefinita, le trova più rapidamente di CMA-ES o PSO e con un budget computazionale inferiore a quello del classico ripiego multistart.
Benchmark
Test 4 dell'articolo: logit a mistura discreto-continua sul dataset di scelta modale di Londra (4 alternative: a piedi, bicicletta, trasporto pubblico, auto; N = 500, R = 500; ripartizione reale tra le classi 0,70/0,30; sensibilità al costo distribuita normalmente). Ogni metodo è usato come inizializzazione dello stimatore di tipo Newton di Biogeme; riportiamo la log-verosimiglianza finale raggiunta (più alta è meglio, cioè meno negativa) e il tempo reale totale. MSB = Multistart Biogeme con M riavvii casuali in [-12, 12].
| Metodo di inizializzazione | Log-verosimiglianza finale | ΔLL vs predefinito | Tempo totale (s) | ΔTempo vs predefinito |
|---|---|---|---|---|
| Biogeme (predefinito) | −294,38 | - | 583 | - |
| Biogeme + BHAMSLE (nostro) | −243,68 | +50,69 (+17,2 %) | 13'796 | +13'212 s (+2'265 %) |
| MSB (M = 10) | −243,78 | +50,60 (+17,2 %) | 15'003 | +14'419 s (+2'472 %) |
| MSB (M = 20) | −243,69 | +50,69 (+17,2 %) | 26'706 | +26'122 s (+4'478 %) |
| MSB (M = 50) | −243,68 | +50,69 (+17,2 %) | 68'062 | +67'479 s (+11'568 %) |
| MSB (M = 100) | −243,68 | +50,69 (+17,2 %) | 106'438 | +105'854 s (+18'151 %) |
Spiccano due aspetti. Primo, l'inizializzazione predefinita di Biogeme resta intrappolata in un ottimo locale peggiore del 17 % rispetto a quello globale, e i metodi di tipo Newton non hanno modo di accorgersene. La ricerca di BHAMSLE, consapevole della struttura, corregge questo difetto guidando lo stimatore oltre il bacino sfavorevole prima ancora che parta. Secondo, BHAMSLE eguaglia la soluzione che il multistart trova alla fine con M = 20 riavvii, ma in circa metà del tempo reale. Con M = 10 riavvii, il multistart resta addirittura leggermente al di sotto di BHAMSLE in qualità e lo supera in tempo di calcolo. Ne consegue che i riavvii a forza bruta pagano un prezzo elevato per non sapere dove cercare, mentre BHAMSLE lo sa perché glielo dice la struttura del problema. Lo stesso schema si ripete in tutte e quattro le configurazioni sperimentali dell'articolo: misture discrete con scelte osservate e sintetiche, misture discreto-continue con entrambe, sui dati di scelta modale Swiss Metro e di Londra.
Dalla documentazione
Tecniche
- Enumerazione dei breakpoint per la verosimiglianza simulata
- Ascesa per coordinate sui parametri MSLE
- Stima di modelli a classi latenti / a mistura
- Aggiornamenti incrementali ln(Σ ± 1) − ln(Σ)
- Confronto con CMA-ES e Biogeme multistart
Stack
- Python
- Biogeme 3.2.14
- Julia (CMA-ES tramite Evolutionary.jl)
- Gurobi (per la baseline MILP)
Un problema simile?