
← Ambiti di competenza/Revenue Management · 2026
Un'euristica di pricing con gap di ottimalità <0,2 % e un'accelerazione fino a 37 milioni di volte rispetto allo stato dell'arte
Il Breakpoint Heuristic Algorithm: risolve il pricing capacitato dove ogni metodo esatto va in timeout, scala a 1'000'000 scenari di domanda con sei prezzi in meno di 8 minuti, batte LAG (specialista del caso capacitato) di 79× e CoBiT (specialista del mixed logit) fino a 37 milioni di volte
<0,2 %
gap di ottimalità medio sui benchmark capacitati dove ogni metodo esatto va in timeout
37 × 10⁶ ×
accelerazione massima rispetto a CoBiT, lo stato dell'arte pubblicato per il pricing specifico per il mixed logit
79×
accelerazione minima rispetto a LAG, la precedente euristica di pricing capacitato
1'000'000
scenari di domanda risolti con 6 prezzi in meno di 8 minuti
Gli algoritmi esatti sono eleganti sulla carta e scomodi in produzione. I team di pricing reali hanno bisogno di risposte in pochi secondi, su istanze con vincoli di capacità, e di una garanzia di qualità che possano difendere in riunione.
Il nostro Breakpoint Heuristic Algorithm soddisfa entrambe le esigenze. Pubblicato su Computers & Operations Research, risolve il CPP capacitato e non capacitato con un gap medio inferiore allo 0,2 %, superando in velocità e qualità tutte le euristiche pubblicate per questa classe di problemi.
Il problema
Il problema di pricing capacitato basato sulle scelte (CPP), cioè il pricing con domanda a scelta discreta quando i prodotti hanno capacità finita, è nettamente più difficile della sua controparte non capacitata. L'aggiunta della capacità distrugge la totale unimodularità del knapsack di ciascun cliente e riporta il modello alla forma MILP: l'euristica lagrangiana di Paneque et al. (2022) va in timeout con 50 estrazioni e 4 prezzi, e il MILP esatto gestisce solo istanze giocattolo. Nessuna delle euristiche esistenti funziona su tutti i modelli di domanda.
Chi lavora sul campo ha bisogno di un'unica euristica robusta che funzioni con tutte le classi di modelli, scali a istanze ad alta dimensionalità e dia una risposta difendibile su quanto si è vicini al vero ottimo.
Cosa abbiamo costruito
Abbiamo esteso il nostro Breakpoint Exact Algorithm a un regime euristico: il BHA enumera i breakpoint lungo un percorso di discesa per coordinate, accetta mosse rapide quando migliorano la funzione obiettivo ed evita l'esplosione combinatoria dei metodi esatti sulle istanze a più prezzi.
La capacità è gestita tramite una coda di priorità esogena, un accorgimento pulito e indipendente dal modello che mantiene lineare il sottoproblema interno e ci consente di riutilizzare tutto il nostro apparato per il caso non capacitato senza toccare la logica di enumerazione esterna.
Abbiamo combinato il BHA con una ricerca locale iterata per sfuggire agli ottimi locali; la variante ILS risultante raggiunge tutti gli ottimi noti sui benchmark mixed logit e, quando il metodo esatto va in timeout, trova soluzioni con un ricavo più alto del BEA esatto.
Sul fronte esatto abbiamo sviluppato nuove disuguaglianze valide per la formulazione QCQP-L, che accelerano la nostra Branch-and-Benders Decomposition; il BHA funge inoltre da warm start di prim'ordine (accelerazioni complessive fino al 54 % con un gap del 10 %, a seconda della dimensione).
Il risultato
Deliverable: il Breakpoint Heuristic Algorithm e la sua estensione Iterated Local Search, un'euristica rapida e scalabile per il problema di pricing basato sulle scelte, capacitato e non capacitato, con qualsiasi DCM a utilità lineare nel prezzo. Sul benchmark di pricing dei parcheggi con capacità, il BHA ottiene un gap di ottimalità medio inferiore allo 0,2 % su tutte le istanze completate e, nel caso non capacitato, scala a 1'000'000 scenari di domanda con sei prezzi in 439 secondi (~7,3 minuti).
Rispetto a LAG (Paneque et al. 2022), la precedente euristica per il CPP capacitato, il BHA è almeno 79× più veloce in tutte le classi di istanze testate. Rispetto a CoBiT (Marandi e Lurkin 2023), il precedente stato dell'arte per il pricing specifico per il mixed logit, il BHA raggiunge accelerazioni fino a 37 milioni di volte (tabella 12, R = 100'000) e l'estensione ILS raggiunge ogni ottimo noto. Abbiamo inoltre derivato nuove disuguaglianze valide per la Branch-and-Benders Decomposition spaziale del nostro precedente articolo su OR Spectrum, con il BHA come warm start di prim'ordine — l'effetto combinato arriva fino al 54 % di accelerazione con un gap di ottimalità del 10 %. Pubblicato open access su Computers & Operations Research, 2026.
Approfondimento tecnico
Il modello dietro il risultato.
Il modello
Aggiungere vincoli di capacità al problema di pricing basato sulle scelte manda all'aria tutto ciò che rendeva trattabile il caso non capacitato. Il knapsack di ciascun cliente non è più totalmente unimodulare, quindi il rilassamento QCQP-L non è più intero e il problema torna a essere un MILP genuinamente combinatorio. Peggio ancora, quando un prodotto esaurisce la capacità, la scelta ottima di ogni cliente dipende da quella di tutti gli altri, il che significa che il trucco dell'aggiornamento incrementale del BEA non funziona più: la funzione obiettivo può essere valutata solo dopo aver assegnato ogni cliente tramite la coda di priorità. Il BHA è costruito attorno a questo vincolo: mantiene l'enumerazione dei breakpoint del BEA, ma la usa lungo una sola dimensione di prezzo alla volta, valutando la funzione obiettivo completa a ogni passo.
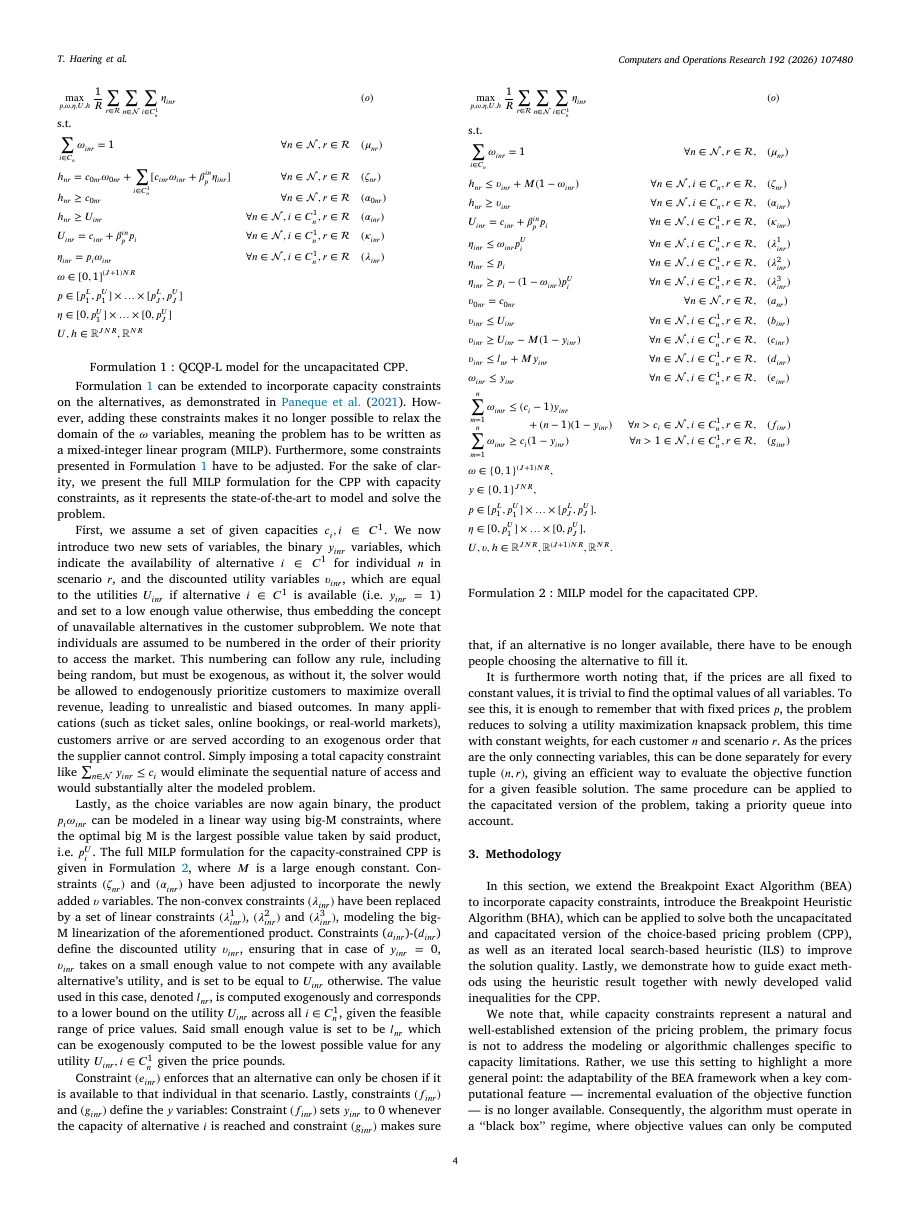
Variabili del CPP capacitato e vincolo della coda di priorità. I clienti sono elaborati in un ordine esogeno (coda dei biglietti, orario di arrivo, priorità di segmento, a seconda di ciò che richiede l'applicazione). La nuova variabile binaria y_inr indica se l'alternativa i è ancora disponibile quando il cliente n arriva nello scenario r; la famiglia di vincoli (f_inr, g_inr nell'articolo) stabilisce che y_inr passa a 0 nel momento in cui le selezioni cumulate dell'alternativa i raggiungono la sua capacità c_i. Sostituire la coda di priorità con una disuguaglianza di capacità globale permetterebbe al solver di riassegnare endogenamente le priorità dei clienti, il che è irrealistico e porterebbe a sottostimare la volatilità del ricavo.
Quanto vi costa la capacità. Ora che ω è effettivamente binaria, il termine bilineare p_i ω_inr deve essere linearizzato con variabili ausiliarie big-M (il MILP originale di Paneque et al.). La riformulazione QCQP-L su cui si basava il nostro lavoro sul caso non capacitato non è più applicabile: il rilassamento LP non è intero, quindi non possiamo rilassare ω. In pratica: l'intera catena algoritmica di pricing1 (B&B spaziale, B&BD, inviluppi di McCormick) crolla, e l'unico approccio esatto rimasto è il MILP, che empiricamente va in timeout per R ≥ 50.
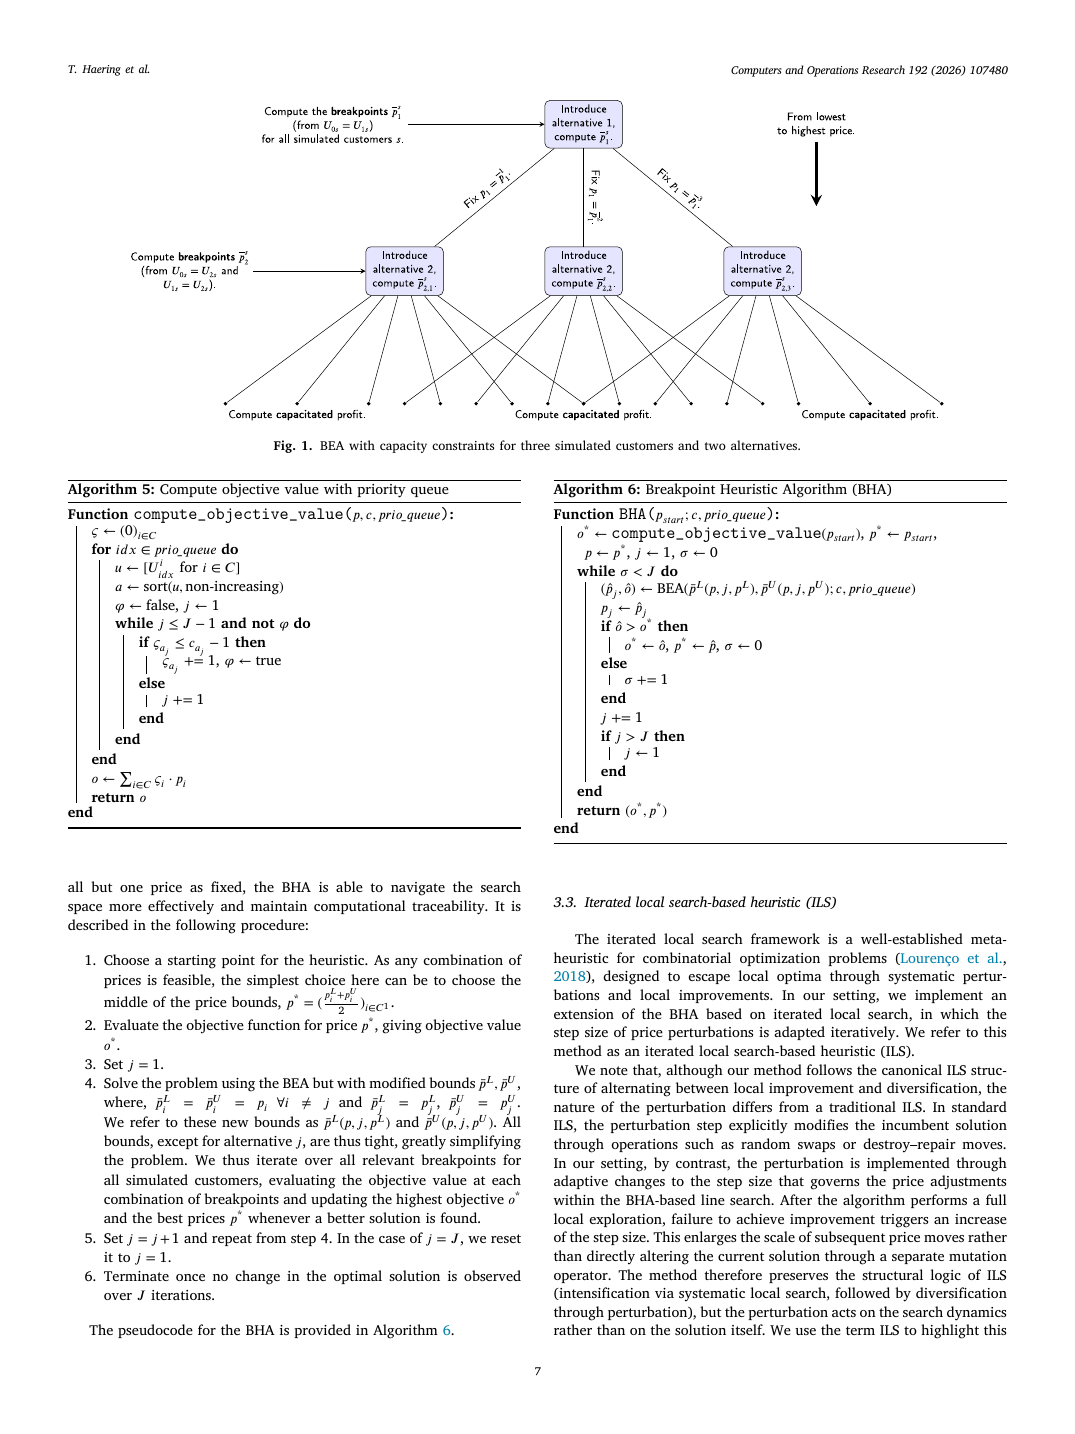
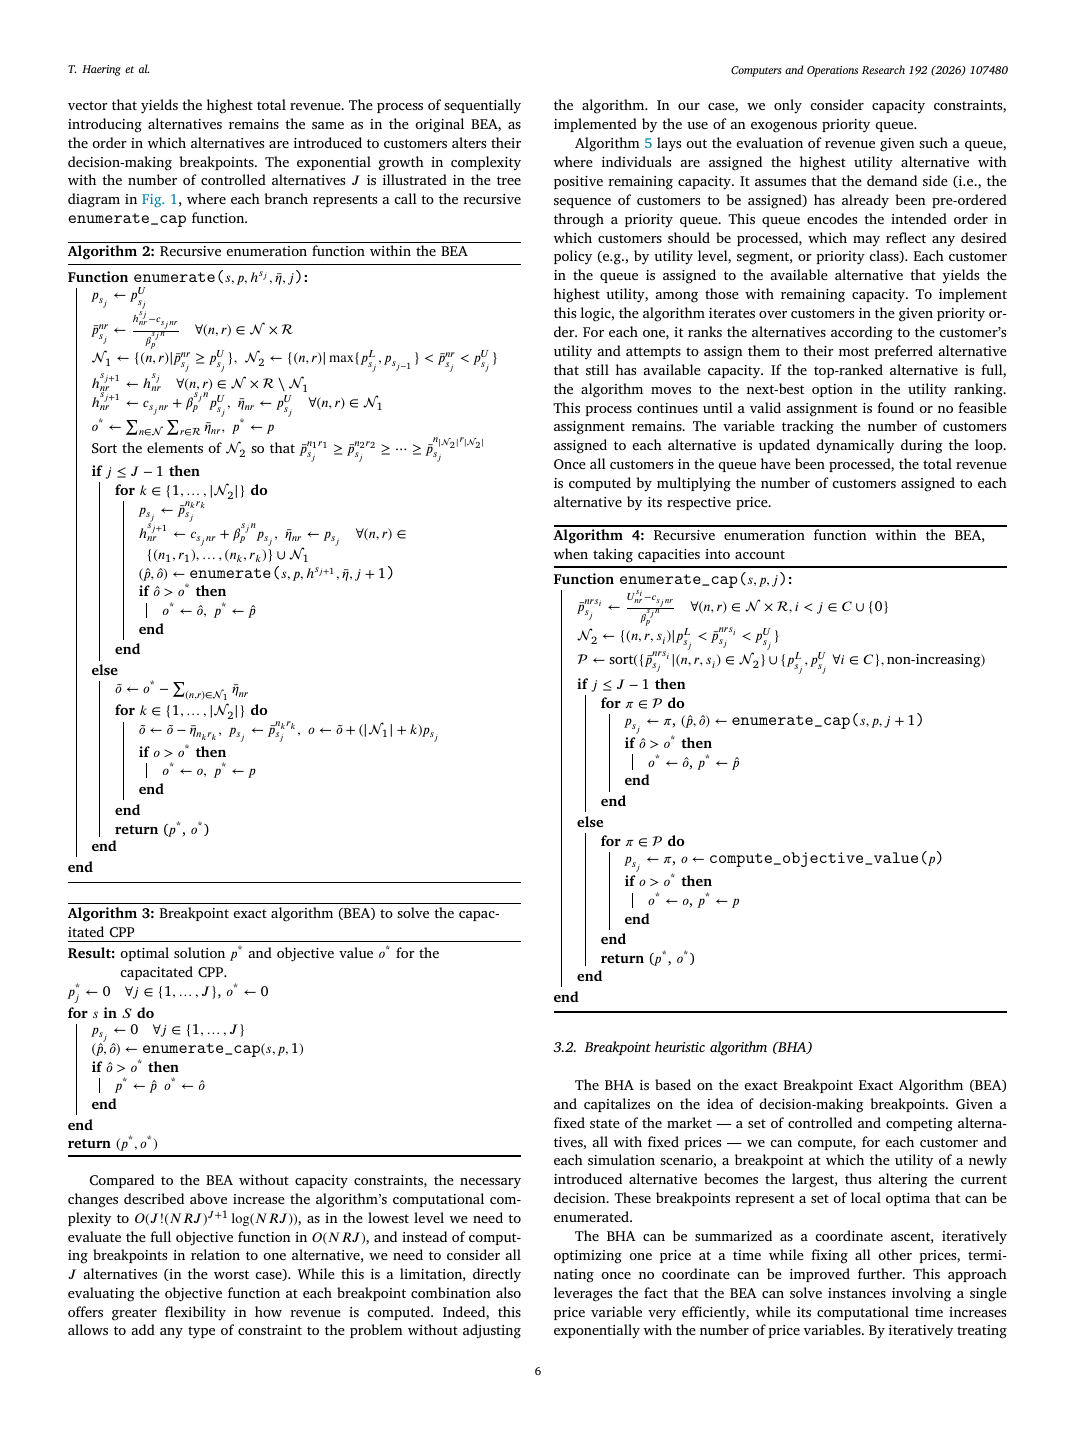
Complessità del BEA capacitato. Abbiamo esteso il BEA sostituendo il suo aggiornamento incrementale della funzione obiettivo con un passaggio di allocazione tramite coda di priorità sulle foglie dell'albero di enumerazione. Questa modifica preserva la correttezza, ma aggiunge un fattore NRJ per ogni livello di ricorsione (in ogni breakpoint dobbiamo considerare tutte le J alternative, non una sola). Asintoticamente: ancora polinomiale in N e R, ancora esponenziale in J, ma la costante moltiplicativa è sensibilmente peggiore rispetto al limite O(J!(NR)^J log NR) del caso non capacitato.
Breakpoint Heuristic Algorithm: ascesa per coordinate sul vettore dei prezzi, in cui ogni passo risolve un BEA a un solo prezzo (la dimensione in cui il BEA costa poco: solo NR breakpoint da valutare, nessun albero di permutazioni). All'iterazione t fissiamo tutti i prezzi tranne j(t), enumeriamo i prezzi candidati (al massimo NR + 2) per quella coordinata nello stato corrente della coda, valutiamo la funzione obiettivo capacitata completa per ogni candidato e scegliamo il migliore. Si ripete ciclicamente sulle dimensioni finché J passate consecutive sulle coordinate non producono alcun miglioramento.
Complessità effettiva del BHA. K è il numero di cicli esterni (empiricamente 5–20 sulle istanze di benchmark), J il numero di passate sulle coordinate per ciclo, NR il numero di breakpoint per coordinata e NRJ il costo di una valutazione della funzione obiettivo tramite coda di priorità. Il termine esponenziale in J che schiaccia il BEA-cap esatto scompare, sostituito da un costo quadratico in NR: è esattamente per questo che il BHA scala a istanze fuori dalla portata del metodo esatto. Il prezzo da pagare: nessun certificato di ottimalità.
Iterated Local Search come involucro. Invece di perturbare la soluzione incumbent dopo ogni terminazione del BHA (l'ILS da manuale), ampliamo il passo e rilanciamo la ricerca unidimensionale. È questo l'operatore di perturbazione: quando la ricerca locale esaurisce l'intorno a passo piccolo, si salta a uno più ampio, lo si riesplora e si accetta in caso di miglioramento. Si continua finché δ supera Δ_max. Empiricamente questo chiude il gap residuo sulle istanze di benchmark: l'ILS raggiunge ogni ottimo noto là dove il BHA lascia sul tavolo ~0,04 %.
Metodo esatto guidato dall'euristica. Forniamo la soluzione del BHA alla nostra Branch-and-Benders Decomposition spaziale (non capacitata) come solido limite inferiore iniziale e, attorno a essa, deriviamo nuove disuguaglianze valide per la formulazione QCQP-L. Effetto combinato sul tempo di calcolo del B&BD per raggiungere un gap di ottimalità del 10 %: fino al 54 % di accelerazione con J = 4 (il regime in cui i metodi esatti sono ancora praticabili). Euristica e metodo esatto ora si aiutano a vicenda.
Quattro contributi algoritmici in un solo articolo: il BEA capacitato, il BHA, l'estensione ILS e il B&BD guidato dal BHA con nuove disuguaglianze valide. Il BHA è la chiave di volta, l'algoritmo che va in produzione, perché fornisce soluzioni quasi ottime in tempi trattabili su istanze di scala realistica che i metodi esatti non riescono a raggiungere. Lo strato ILS è l'opzione che attivate quando la qualità della soluzione conta più del tempo di calcolo. Le disuguaglianze valide e la guida euristica sono ciò che permette ora al B&BD esatto di competere con gli algoritmi specializzati per il mixed logit (CoBiT, LAG) sul loro stesso terreno, e di vincere, con fattori di 10⁴ – 10⁷.
Benchmark
Test 2 dell'articolo: pricing capacitato dei parcheggi sul caso di studio di Ibeas et al. (2014), N = 50 clienti, capacità (20, 20) per J = 2 e (15, 15, 15, 15) per J = 4. Tutti i tempi in secondi. MILP e BEA sono esatti (gap = 0); CMA-ES è una baseline generica basata su strategie evolutive; BHA e ILS sono nostri. Su ogni istanza completata il BHA restituisce lo stesso ricavo dei metodi esatti con uno scarto massimo dello 0,2 %, e l'ILS raggiunge esattamente l'ottimo.
| R | J | MILP | BEA (capacitato) | CMA-ES | BHA (nostro) | ILS (nostro) |
|---|---|---|---|---|---|---|
| 2 | 2 | 5 | 0,5 | 0,6 | 0,2 | 1,2 |
| 10 | 2 | 173 | 12 | 2,3 | 0,6 | 21 |
| 25 | 2 | 3'224 | 174 | 8 | 3,6 | 129 |
| 50 | 2 | > 5 h | 1'291 | 18 | 8 | 558 |
| 100 | 2 | > 25 h | 9'914 | 132 | 51 | 2'793 |
| 250 | 2 | > 45 h | > 45 h | 1'084 | 435 | 16'357 |
| 10 | 4 | > 10 h | > 10 h | 23 | 6 | 517 |
| 100 | 4 | > 45 h | > 45 h | 1'693 | 828 | 34'963 |
Il MILP si arrende a R = 50 (limite di 5 ore raggiunto, gap di ricavo > 8 % rispetto al vero ottimo). Il BEA porta più avanti la bandiera dei metodi esatti, risolvendo R = 100, J = 2 in 2,75 ore, ma è già due ordini di grandezza più lento del BHA, che chiude la stessa istanza in 51 secondi. A R = 250 anche il BEA va in timeout, mentre il BHA termina ancora in 7 minuti. Con quattro prezzi il quadro è ancora più netto: ogni metodo esatto fallisce a R = 10, J = 4, ma il BHA restituisce soluzioni quasi ottime sull'intero intervallo R = 10..200. CMA-ES è un utile termine di confronto, una metaeuristica affermata, ma è 2–10× più lento del BHA e restituisce sistematicamente un ricavo inferiore del 2–3 %. Oltre questo test: la tabella 6 dell'articolo mostra il BHA che risolve J = 6, R = 1'000'000 in 439 secondi (meno di 8 minuti); la tabella 12 mostra il BHA che supera CoBiT, specifico per il mixed logit, con fattori di accelerazione da 3,5 × 10⁴ a 3,7 × 10⁶.
Dalla documentazione
Tecniche
- Ricerca dei breakpoint per ascesa lungo le coordinate
- Ricerca locale iterata (passo adattivo)
- Gestione della capacità con coda di priorità
- Disuguaglianze valide per il QCQP-L
- Guida euristica per il B&BD spaziale
Stack
- Python
- Gurobi 13
- Julia (confronto con CoBiT)
- Cicli interni in C++
Un problema simile?